从零构建Z-Image的推理
从零构建Z-Image的推理
本文讲解如何仅用
torch.nn.Module从零搭建 Z-Image-Turbo 文生图模型——
不调用任何现成的diffusers/DiffSynth运行时,而是手写每一个部件:Qwen3 文本编码器、
6B 扩散变换器(DiT)、Flux 风格 VAE 解码器、流匹配调度器,以及一套三态逐层显存管理器,
再直接从 HuggingFace safetensors checkpoint 加载预训练权重,从而产出真实图像。
完整项目代码在:https://github.com/huan-yin/Z_Image_Inference_From_Scratch文中所有 shape 均以 prompt
"a cute girl"+ 1024×1024 + 8 步 + seed=42 + cfg=1.0 为例,
并通过实际运行真实模型(加载预训练权重、bfloat16、CUDA、RTX 4060 Laptop 8GB)验证,非纸面推算。
目录
- 整体架构:从零构建需要哪些部件
- 模型配置
- 部件一:文本编码器(Qwen3 4B)
- 部件二:流匹配调度器
- 部件三:DiT 扩散变换器
- 部件四:VAE 解码器
- 部件五:8GB 显存管理(三态机)
- 完整前向传播 Shape 追踪(已验证)
- 关键设计要点
1. 整体架构:从零构建需要哪些部件
Z-Image-Turbo 是一个流匹配(Flow Matching)文生图扩散变换器。从零构建它,需要依次实现下面 5 个部件:
1 | |
构建顺序遵循数据流:先把文本编码成上下文向量,再从纯噪声出发迭代去噪,最后把潜空间解码回像素。调度器贯穿去噪循环,显存管理器贯穿全程——这两者是让 6B+4B 大模型跑进 8GB 显卡的关键。
与上一篇 [从零构建Qwen2.5VL的推理] 的区别:那篇是多模态理解(图→文,自回归解码),本篇是多模态生成(文→图,流匹配迭代)。两者的"融合"方向相反,但都用 Transformer 做 token 间注意力。
2. 模型配置
所有超参硬编码为常量,与 Tongyi-MAI/Z-Image-Turbo 的官方实现一致。
DiT(ZImageDiT)
| 项 | 值 | 说明 |
|---|---|---|
| dim | 3840 | DiT 隐藏维度 |
| n_layers | 30 | 统一 transformer 层数 |
| n_refiner_layers | 2 | noise_refiner / context_refiner 各 2 层 |
| n_heads | 30 | 注意力头数(n_kv_heads=30,非 GQA) |
| head_dim | 128 | 3840 / 30 |
| in_channels | 16 | 潜空间通道数 |
| patch_size | 2 | 空间 patch 边长 |
| f_patch_size | 1 | 时间/帧 patch 边长 |
| rope_theta | 256.0 | 3D RoPE 基频 |
| axes_dims | (32, 48, 48) | 3D RoPE 三段维度(T/H/W) |
| axes_lens | (1024, 512, 512) | 三段位置上限 |
| cap_feat_dim | 2560 | 文本特征维度(对齐 Qwen3 hidden) |
| qk_norm | True | 对 q/k 做 RMSNorm |
| ADALN_EMBED_DIM | 256 | 时间步嵌入维度(adaLN 输入) |
| SEQ_MULTI_OF | 32 | 序列填充对齐粒度 |
派生常量:
1 | |
文本编码器(Qwen3 4B)
| 项 | 值 | 说明 |
|---|---|---|
| hidden_size | 2560 | Qwen3 隐藏维度 |
| num_hidden_layers | 36 | 层数 |
| num_attention_heads | 32 | query 头数 |
| num_key_value_heads | 8 | KV 头数(GQA,32/8=4) |
| head_dim | 128 | |
| intermediate_size | 9728 | MLP 中间维度 |
| vocab_size | 151936 | |
| rope_theta | 1,000,000 | RoPE base |
| max_position_embeddings | 40960 | |
| max_sequence_length | 512 | encode_prompt 的截断/填充长度 |
| tie_word_embeddings | True | 输出层共享 embedding(推理时 lm_head 被丢弃) |
关键:取倒数第二层
hidden_states[-2]作为文本特征,不是最后一层。
VAE 解码器(Flux 风格)
| 项 | 值 | 说明 |
|---|---|---|
| in_channels | 16 | 潜空间通道 |
| out_channels | 3 | RGB |
| scaling_factor | 0.3611 | 潜空间缩放 |
| shift_factor | 0.1159 | 潜空间平移 |
| conv_in | 16 → 512 | |
| blocks | 18 个 | 1 mid(3) + 4 up(15),含 3 个 UpSampler |
| conv_out | 128 → 3 |
调度器(FlowMatchScheduler)
| 项 | 值 | 说明 |
|---|---|---|
| num_train_timesteps | 1000 | 训练时间步上限 |
| num_inference_steps | 8 | 推理步数(Turbo) |
| shift | 3.0 | 高噪声偏移 |
| sigma_min / sigma_max | 0 / 1 | 流匹配 σ 范围 |
3. 部件一:文本编码器(Qwen3 4B)
目标:把 prompt 字符串变成 DiT 的上下文特征 prompt_embeds (11, 2560)。
Z-Image 复用 Qwen3-4B 作为文本编码器,但不取 logits,而是取倒数第二层隐藏态。本文直接用 transformers.Qwen3Model 搭骨架,权重从官方 checkpoint 加载。
3.1 chat 模板 + tokenize
1 | |
实测:raw prompt "a cute girl" 只有 3 个 token(a / cute / girl);套上 chat 模板后变成 11 个 token(<|im_start|> user \n a cute girl <|im_end|> \n <|im_start|> assistant \n)。padding 到 max_length=512,前 11 位有效、后 501 位是 pad。
注:这里
enable_thinking=True传了,但 Z-Image 的 tokenizer 模板对编码场景只展开成上面的标准 user/assistant 格式(不带<think>块)——文本编码只关心 prompt 语义,不需要思考链。
3.2 取倒数第二层 + 去 padding
1 | |
为什么不取最后一层?最后一层更贴近"预测下一个 token",而倒数第二层保留更丰富的语义表征,更适合作为生成任务的上下文条件。去掉 pad 是为了不让 501 个无意义 token 进入 DiT。
验证结果:
| 输出 | shape | 值 |
|---|---|---|
input_ids |
(1, 512) |
11 有效 + 501 pad |
attention_mask |
(1, 512) |
11 个 1 |
hidden_states[-2] |
(1, 512, 2560) |
倒数第二层 |
prompt_embeds |
(11, 2560) |
去 pad 后,bfloat16 |
这 (11, 2560) 就是下文 DiT 的 cap_feats(caption features)。
4. 部件二:流匹配调度器
目标:给定步数生成 σ 序列,并在每步做欧拉更新。
4.1 σ 与 timestep 生成
1 | |
shift=3.0 把 σ 往高噪声方向挤压,让更多步数花在大噪声区——这对流匹配生成质量很关键。
实测(8 步,shift=3.0):
| step | σ | timestep (σ×1000) |
|---|---|---|
| 0 | 1.0 | 1000.0 |
| 1 | 0.9545 | 954.55 |
| 2 | 0.9 | 900.0 |
| 3 | 0.8333 | 833.33 |
| 4 | 0.75 | 750.0 |
| 5 | 0.6429 | 642.86 |
| 6 | 0.5 | 500.0 |
| 7 | 0.3 | 300.0 |
4.2 欧拉步
流匹配的 ODE:从噪声 (σ=1)积分到数据 (σ=0),速度 。一步欧拉:
1 | |
这里
model_output是 DiT 返回的速度,(σ_next − σ) < 0,所以每步把潜变量沿速度方向往数据推。最后一帧σ_next=0落到干净潜空间。
4.3 两个隐蔽变换:1000−t 与取负
DiT 内部对时间步做了两次变换(见 model_fn_z_image_turbo):
1 | |
1000 − t:pipeline 传进来的是σ×1000(高噪声=1000);DiT 内部用1000 − t喂给嵌入器,于是高噪声对应小 t、低噪声对应大 t。这是 Z-Image 对时间步编码的约定。- 取负:DiT 原始输出
x_out取负后作为速度返回。结合调度器的prev = sample + v·(σ_next − σ),等价于让模型预测 、再取负得 ,与流匹配速度定义对齐。
实测:step 0 时 timestep=1000 → 1000−t=0;step 7 时 timestep=300 → 1000−t=700。
一个精度细节:
timestep_tensor被转成 bfloat16 再进 DiT,于是954.55在 bf16 下被量化成956.0(step 1 实测)。这是 bf16 7 位尾数的固有限制,对生成质量无可观测影响,但解释了日志里 timestep 的细微跳变。
5. 部件三:DiT 扩散变换器
这是核心。目标:latents (1,16,128,128) + prompt_embeds (11,2560) + timestep → noise_pred (1,16,128,128)。
5.1 时间步嵌入:TimestepEmbedder
1 | |
t_noisy (1, 256) 之后会作为 adaLN 的条件,调制每个带调制的 transformer 块。
验证:t_noisy = (1, 256) ✓
5.2 Patchify:把潜空间切成 token
1 | |
一个 token = 一个 2×2 空间块 × 16 通道 = 64 维。128/2 = 64,所以 64×64 = 4096 个图像 token。
与 Qwen2.5-VL 的对比:那边视觉用 3D Conv 做 patch embed + 2×2 Merger 压缩;这里直接用
view+permute切块,再用一个nn.Linear(64, 3840)抬升到 DiT 维度,没有 Merger——因为patch_size=2已经把 128×128 压到 64×64 了。
验证:x (patched) = (4096, 64) ✓
5.3 3D RoPE:时间/高/宽三段旋转
DiT 用 3D RoPE:head_dim=128 拆成 时间(32) + 高(48) + 宽(48) 三段,每段用对应维度的位置独立旋转。位置由 patchify_and_embed 构造的 3D 坐标 (t, h, w) 决定。
位置构造(caption 与 image 分别处理,且都对齐到 SEQ_MULTI_OF=32):
- caption:
cap_ori_len=11,padding 到 32(补 21 个 pad token)。位置create_coordinate_grid(size=(32,1,1), start=(1,0,0))→ 时间轴1..32,h=w=0。 - image:
4096个 token(已对齐 32,无需 padding)。位置create_coordinate_grid(size=(1,64,64), start=(33,0,0))→ 时间恒为33,h=0..63、w=0..63。
读法很妙:
| token | t | h | w | 说明 |
|---|---|---|---|---|
| caption[0…10](有效) | 1…11 | 0 | 0 | 文本沿时间轴排开 |
| caption[11…31](pad) | 12…32 | 0 | 0 | 被 cap_pad_token 覆盖 |
| image[0] (左上) | 33 | 0 | 0 | 图像固定在 t=33,铺 2D 网格 |
| image[1] | 33 | 0 | 1 | 同行 w+1 |
| image[64] (换行) | 33 | 1 | 0 | 新行 h+1 |
| image[4095] (右下) | 33 | 63 | 63 | 网格末尾 |
- 文本 token 只有时间维在变(
h=w=0),相当于一维时序 RoPE; - 图像 token 只有空间维在变(
t=33恒定),相当于二维空间 RoPE; - 两类 token 靠时间轴区分(文本 1…32、图像 33),旋转后天然带"先文本后图像"的顺序感。
RoPE 频率(RopeEmbedder,θ=256):
1 | |
64 个 complex = 128 real = head_dim。旋转时把 q/k 的 head_dim=128 重排成 (…, 64, 2) → view 成 64 个 complex,与 freqs_cis 逐项复乘:
1 | |
验证:freqs_cis = (1, L, 64) complex,heads=30, head_dim=128 ✓
5.4 三段式 transformer:refiner × 2 + 统一 × 30
Z-Image 的 DiT 不是一上来就拼接图文,而是先各自精炼,再统一融合:
1 | |
- noise_refiner(2 层,
layer_id=1000,1001,带调制):只处理图像 token,用t_noisy做 adaLN。先让噪声潜变量"自我整理"。 - context_refiner(2 层,
layer_id=0,1,无调制):只处理文本 token(padding 到 32),adaln=None。先让文本特征"自我整理"。 - unified(30 层,
layer_id=0..29,带调制):拼接cat([x, cap]) = (1, 4128, 3840),图文 token 互相做全注意力,再用t_noisy调制。
4128 = 4096(图像)+ 32(文本 padding 后)。注意文本只占 32 个 token,远少于图像的 4096——这也是文本条件能高效注入的原因。
验证(step 0,每层 block 的输入):
1 | |
[M] = 带调制,[-] = 无调制。
5.5 Transformer 块内部
每个块 = 注意力 + SwiGLU FFN,带调制时用 adaLN 注入 t_noisy:
1 | |
无调制的块(context_refiner)退化为标准 pre-norm 残差,scale=1, gate=1。
注意力(n_heads=n_kv_heads=30,非 GQA):
1 | |
- QK-Norm:q/k 在 RoPE 前各做一次 RMSNorm,稳定大维度(3840)下的注意力数值。
- 全注意力:unified 段里图文 token 互相全 attend,没有窗口/分块——4128 长度对 SDPA 完全可接受。
FFN:无 bias SwiGLU,w2(silu(w1(x)) * w3(x)),中间维度 10240。
5.6 FinalLayer + unpatchify
1 | |
注意 linear 输出维度 64 = 2×2×1×16 = OUT_CHANNELS,即每个 token 还原成一个 2×2×16 的 patch。
1 | |
4128 个 token 里只有前 4096 是图像(后 32 是文本),unpatchify 只还原图像部分,文本 token 直接丢弃——文本只负责"条件注入",不产生像素。
验证:FinalLayer out = (1, 4128, 64),model_fn out = (1, 16, 128, 128) ✓
6. 部件四:VAE 解码器
目标:latents (1,16,128,128) → image (1,3,1024,1024)。
Z-Image 用 Flux 风格的 VAE 解码器(只解码,不编码——编码在训练时用,推理只需要解码)。
6.1 反归一化 + conv_in
1 | |
6.2 18 个块:mid + 4 个 up stage
1 | |
3 次 UpSampler(最近邻 ×2 + Conv)把空间 128 → 256 → 512 → 1024,通道 512 → 512 → 256 → 128。
- ResnetBlock:
GroupNorm→SiLU→Conv×2 + 残差,通道变化时用 1×1 conv shortcut。 - VAEAttentionBlock:
GroupNorm → reshape (B, H·W, C) → LinearAttention → reshape 回 + 残差。这里的LinearAttention其实就是标准 SDPA(1 头,head_dim=512),只在 mid block(128×128=16384token,潜空间最小分辨率)用一次–注意力是 O(n²),放到后续256²/512²/1024²分辨率上开销爆炸。 - UpSampler:
F.interpolate(scale=2, nearest) → Conv2d(3×3)。
6.3 输出头 + 转 PIL
1 | |
验证:latents in = (1,16,128,128),vae out = (1,3,1024,1024),final image = 1024×1024 RGB ✓
7. 部件五:8GB 显存管理(三态机)
这是本项目的招牌特性:6B DiT + 4B 文本编码器 + Flux VAE,全 bfloat16 精确权重,跑进 8GB 显卡。不用量化、不用 4-bit,只靠逐层 offload。
7.1 三件套
-
meta 设备构造(
skip_model_initialization)用
torch.device("meta")构造模型,所有参数不分配显存、不随机初始化。避免"先全量随机初始化再覆盖"的瞬时峰值。 -
assign=True权重加载1
model.load_state_dict(sd, strict=False, assign=True)assign=True是指针赋值而非拷贝到预分配 buffer,配合 meta 构造,加载过程零额外显存。 -
三态逐层 offload(
AutoWrappedLinear/AutoWrappedModule)每个
nn.Linear/RMSNorm/LayerNorm/Embedding/Conv2d/GroupNorm被包进一个状态机:状态 含义 位置 offload(0)父模型未激活,权重休眠 CPU(bf16) onload(1)父模型激活,待命 CPU(bf16) preparing(2)即将计算,搬上 GPU CUDA(bf16) 1
2
3
4
5def forward(self, x):
if self.state == 1 and self.check_free_vram(): # onload 且显存够
self.preparing() # → 搬上 GPU
weight, bias = self.computation() # 取 GPU 上的权重
return F.linear(x, weight, bias)check_free_vram()在每次前向前查torch.cuda.mem_get_info,只有余量低于vram_limit(默认总显存−0.5GB)才上 GPU,否则在 CPU 上就地算。
7.2 模型级串行调度
pipeline 在三个阶段显式切换驻留模型,任意时刻只有一个模型在 GPU:
1 | |
_load_models_to_device 把不在名单里的模型 offload()、把名单里的 onload(),并 torch.cuda.empty_cache()。模型内部再逐层 preparing。所以峰值显存 ≈ 单个最大层,而非整个模型。
7.3 一个精度细节:Qwen3 的 RoPE inv_freq 必须留 float32
整模型 .to(bf16) 会把 buffer 也降精度,但 Qwen3 的 RoPE inv_freq 是 float32 且在 apply_rotary_emb 里 .float() 后使用。若降成 bf16 会永久丢精度、改变 prompt embedding。所以本实现只对 parameters 做 offload dtype 转换,buffer 保留原 dtype——这与 DiffSynth 的做法一致。
1 | |
8. 完整前向传播 Shape 追踪(已验证)
输入:prompt="a cute girl",1024×1024,8 步,seed=42,cfg=1.0。以下 shape 全部经实际运行验证(bfloat16 / CUDA / RTX 4060 Laptop 8GB,VRAM 管理开启)。
8.1 文本编码
| 步骤 | 张量 | shape | 实测值 |
|---|---|---|---|
| raw prompt | tokens | 3 | a / cute / girl |
| chat 模板 | tokens | 11 | 含 im_start / im_end 等 |
| tokenize | input_ids |
(1, 512) | 11 有效 + 501 pad |
| mask | attention_mask |
(1, 512) | 11 个 1 |
| Qwen3 forward | hidden_states[-2] |
(1, 512, 2560) | 倒数第二层 |
| 去 pad | prompt_embeds |
(11, 2560) | bfloat16 |
8.2 调度器
| 量 | 实测值 |
|---|---|
sigmas |
[1.0, 0.9545, 0.9, 0.8333, 0.75, 0.6429, 0.5, 0.3] |
timesteps |
[1000, 954.55, 900, 833.33, 750, 642.86, 500, 300] |
8.3 噪声 / 潜变量
| 步骤 | 张量 | shape | 实测值 |
|---|---|---|---|
| 随机噪声 | noise |
(1, 16, 128, 128) | seed=42 |
| 初始潜变量 | latents |
(1, 16, 128, 128) | = noise |
8.4 DiT 单步(以 step 0 为例)
| 步骤 | 张量 | shape | 实测值 |
|---|---|---|---|
| 输入 | latents |
(1, 16, 128, 128) | |
| rearrange | image |
(16, 1, 128, 128) | C B H W |
| timestep | 1000−t |
标量 | 0.0 |
| 时间步嵌入 | t_noisy |
(1, 256) | |
| patchify | x |
(4096, 64) | 64=2·2·16 |
| cap(pad 后) | cap_feats |
(32, 2560) | 11 有效 + 21 pad |
| 位置 | x_pos_ids |
(4096, 3) | t=33, h,w=0…63 |
| 位置 | cap_pos_ids |
(32, 3) | t=1…32, h=w=0 |
| pad mask | x_pad_mask sum |
0 | 图像无需 pad |
| pad mask | cap_pad_mask sum |
21 | 文本 pad 21 |
| x_embedder | x |
(1, 4096, 3840) | Linear(64,3840) |
| RoPE | x_freqs_cis |
(1, 4096, 64) complex | |
| noise_refiner ×2 | block in | (1, 4096, 3840) | 调制 [M] |
| cap_embedder | cap |
(1, 32, 3840) | RMSNorm+Linear |
| RoPE | cap_freqs_cis |
(1, 32, 64) complex | |
| context_refiner ×2 | block in | (1, 32, 3840) | 无调制 [-] |
| 拼接 | unified |
(1, 4128, 3840) | 4096+32 |
| unified RoPE | unified_freqs_cis |
(1, 4128, 64) complex | |
| unified ×30 | block in | (1, 4128, 3840) | 调制 [M] |
| FinalLayer | out | (1, 4128, 64) | 64=OUT_CHANNELS |
| unpatchify | x_out |
(1, 16, 128, 128) | 取前 4096 |
| 取负 | model_fn out |
(1, 16, 128, 128) | 速度 v |
注意力每层:q,k,v = (1, 30, L, 128),heads=30, head_dim=128,QK-Norm + 3D RoPE。
8.5 去噪循环(8 步)
每步 shape 完全一致(只有 t_noisy 的值变),重复 8 次:
| step | timestep | 1000−t | t_noisy |
|---|---|---|---|
| 0 | 1000.0 | 0 | (1, 256) |
| 1 | 956.0* | 44 | (1, 256) |
| … | … | … | (1, 256) |
| 7 | 300.0 | 700 | (1, 256) |
*step 1 的
954.55被 bf16 量化成956.0(见 §4.3)。
每步后 latents = scheduler.step(noise_pred, t, latents),shape 不变 (1,16,128,128),但内容逐步从噪声走向数据。
8.6 VAE 解码
| 步骤 | 张量 | shape | 实测值 |
|---|---|---|---|
| 输入 | latents |
(1, 16, 128, 128) | bfloat16 |
| 反归一化 | hidden | (1, 16, 128, 128) | /0.3611+0.1159 |
| conv_in | hidden | (1, 512, 128, 128) | |
| mid(3 块) | (1, 512, 128, 128) | 不上采样 | |
| up_1(3 resnet+↑) | (1, 512, 256, 256) | ↑2 | |
| up_2(3 resnet+↑) | (1, 512, 512, 512) | ↑2 | |
| up_3(3 resnet+↑) | (1, 256, 1024, 1024) | ↑2,512->256 | |
| up_4(3 resnet) | (1, 128, 1024, 1024) | 不上采样,256->128 | |
| conv_out | image |
(1, 3, 1024, 1024) | bfloat16 |
| 转 PIL | 1024×1024 | RGB |
8.7 端到端 Shape 流转图
1 | |
8.8 端到端实测输出
对 prompt="a cute girl" 实际运行(8 步,bfloat16,CUDA,VRAM 管理 7.5GB 上限)生成:
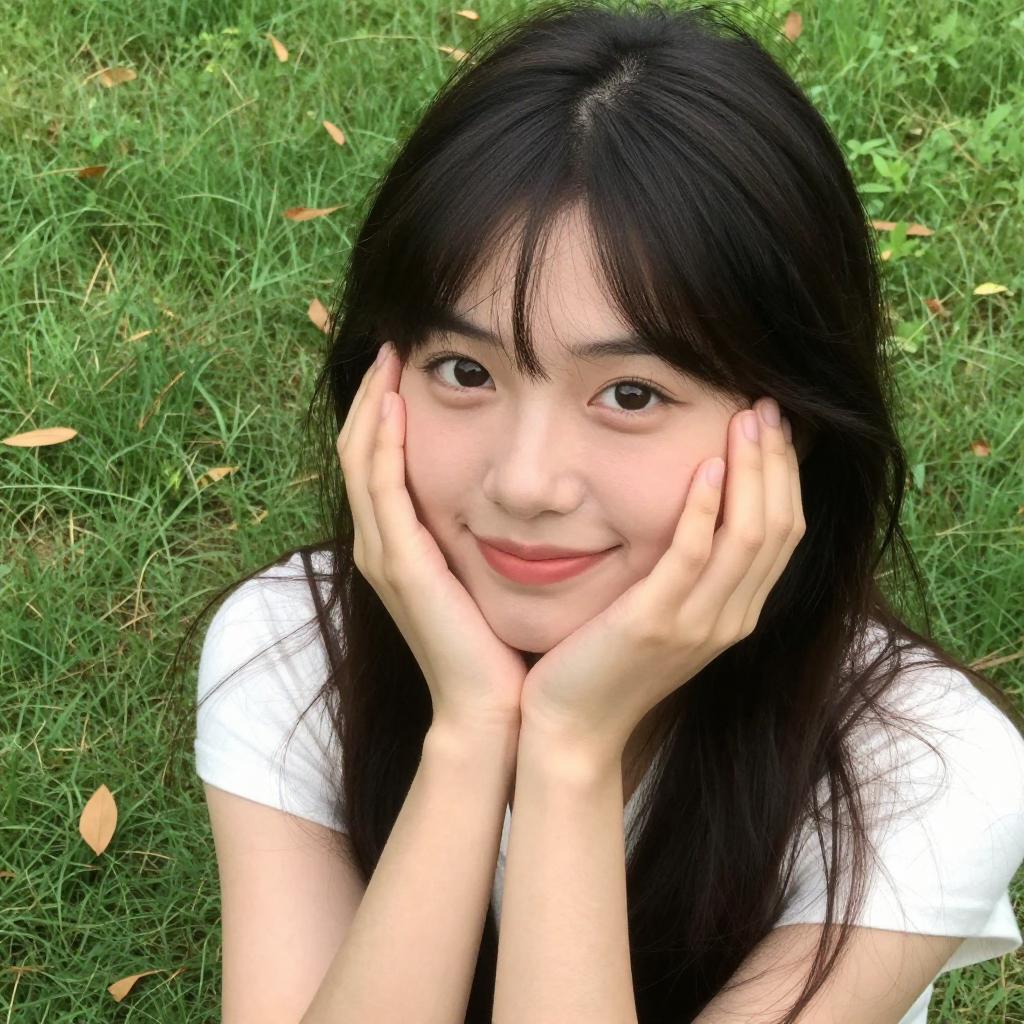
prompt="a cute girl",1024×1024,8 步,seed=42,cfg=1.0。即上文所有 shape 追踪的同一轮运行产物。
9. 关键设计要点
9.1 先精炼再融合:refiner × 2 + 统一 × 30
不直接拼接图文做注意力,而是先用 2 层 noise_refiner 整理图像、2 层 context_refiner 整理文本,再拼成 4128 长序列过 30 层统一 transformer。各自精炼降低初始噪声尺度差异,融合更稳。
9.2 3D RoPE:文本走时间轴、图像走空间轴
head_dim=128 拆成 T(32)+H(48)+W(48)。文本 token 位置 (t=1..32, h=0, w=0),图像 token 位置 (t=33, h=0..63, w=0..63)——文本在时间轴上排开,图像在固定时间的二维空间网格上铺开。两类 token 靠时间轴区分,旋转内积天然编码"先文后图"的顺序与空间相邻性。这和 Qwen2.5-VL 的 M-RoPE 思路同源,但这里图像是生成目标而非输入。
9.3 adaLN 注入时间步
t_noisy (1,256) 通过 adaLN 调制每个带调制的块:产出 scale_msa/gate_msa/scale_mlp/gate_mlp 四组参数,对 attention 和 FFN 做 scale + tanh gate。这让同一组权重能跨时间步条件化——去噪早晚期行为由时间步嵌入驱动。context_refiner 不带调制(文本不受时间步影响)。
9.4 QK-Norm
q/k 在 RoPE 前各做一次 RMSNorm(每头独立)。dim=3840 的大模型下注意力 logits 易爆炸,QK-Norm 把 q/k 归一化到单位方差,稳定训练与推理。
9.5 patch_size=2 与 unpatchify
128×128 潜空间按 2×2 切成 64×64=4096 token,每 token 2·2·16=64 维。FinalLayer 输出 (1,4128,64),只取前 4096 还原成 (1,16,128,128)——文本 32 token 不产像素,只做条件。
9.6 SEQ_MULTI_OF=32 填充对齐
caption 11 补到 32(补 21 个 pad token,用 cap_pad_token 覆盖特征、用 pad mask 标记)。图像 4096 已整除 32 无需 pad。对齐到 32 是为了 SDPA / 矩阵乘的硬件友好(32 是 GPU 张量核的友好粒度),代价是多了 21 个无效 token,可忽略。
9.7 流匹配 + shift=3.0
σ 从 1 线性到 0 共 8 点,再用 σ' = 3σ/(1+2σ) 把分布压向高噪声区。8 步 Turbo 配 cfg=1.0(无需负 prompt)即可出高质量图——这是 Turbo 蒸馏的收益。
9.8 8GB 显存:meta + assign + 三态 offload
三件套缺一不可:meta 构造免随机初始化峰值、assign=True 免加载拷贝峰值、三态机保证任意时刻只有"当前模型的当前层"在 GPU。模型级串行调度(text_encoder→dit→vae)+ 层级 check_free_vram 决定是否上 GPU。全程精确 bfloat16,无量化。
9.9 两个易错的精度点
- Qwen3 RoPE
inv_freq留 float32:整模型.to(bf16)会伤精度,只转参数不转 buffer。 - timestep 量化:
954.55在 bf16 下变956.0,属正常现象。
9.10 局限
- 仅 batch=1、单 prompt、无负 prompt(cfg=1.0)
- 8 步 Turbo 专用,未支持多步高精度模式
- 8GB 卡需开 VRAM 管理(逐层 offload 牺牲速度,8 步约 100s)
- 不使用 FlashAttention / fused kernel,为可读性牺牲吞吐
- VAE 只实现解码(推理只需解码)