如何给DiT添加图像控制条件
如何给 DiT 添加图像控制条件
1. 背景:为什么要在 DiT 中注入图像条件?
DiT 将图像生成从 U-Net 的卷积归纳偏置转移到 Transformer 的序列建模上。与文本条件(text embedding)相比,图像条件包含更丰富的空间结构、风格、语义和布局信息。给 DiT 添加图像控制条件,可实现:
- ControlNet 式控制:边缘、深度、姿态、分割图等空间引导;
- IP-Adapter 式风格/内容迁移:用参考图驱动生成风格和主体;
- 图像修复(Inpainting):根据原图与 mask 补全或修改指定区域;
- 图像编辑(Image Editing):在保持原图大部分内容的前提下按指令修改;
- 多图融合/参考生成:将多张参考图的内容整合到一张目标图中。
不同任务对“控制粒度”要求不同,因此业界演化出多种条件注入方案。
2. 图像条件注入的方法分类
| 方法 | 图像条件编码 | 注入/融合方式 | 备注 |
|---|---|---|---|
| FLUX ControlNet | 控制图 VAE 编码(canny/depth/pose 等)+ mode embedding | 逐层残差相加(residual add) | 冻结主 DiT,额外训练控制分支 DiT 副本,输出残差注入主网络各层 |
| FLUX IP-Adapter | CLIP 图像编码 | cross attention | 图像特征投影为 K/V,与生成路径 Q 做交叉注意力 |
| FLUX Fill | 条件图像 VAE 编码(masked image)+ mask token | channel concat | 将 masked image latent 与 mask 在 channel 维度拼到噪声 latent 上 |
| OminiControl、 HiFi-Inpaint、 FLUX Kontext |
图像 VAE 编码 | token concat | 参考图 latent 与噪声 latent 在序列维度拼接,原图 token 与噪声 token 拼接,通过 timestep/位置编码区分 |
| Insert Anything | SigLIP 图像编码 | diptych + channel concat + token concat | 参考图像和masked image进行按宽度拼接(diptych), 之后利用VAE编码进行channel concat(FLUX FIll),参考图像还利用SigLIP编码进行token concat(FLUX Redux) |
| Z-Image-Edit | SigLIP2 编码 + 图像 VAE 编码 | token concat | 融合语义 token 与 latent token 和 noise token 序列拼接 |
| Qwen-Image-Edit、 Longcat-Image-Edit、 JoyAI-Image-Edit、 Boogu-Image-Edit |
VLM 编码 + 图像 VAE 编码 | token concat | VLM 语义 token 与图像 latent token 和 noise token 序列拼接 |
3. 主流技术路线详解
本节按照“图像条件编码 → 注入/融合方式”的主线,对表 1 中的方法进行系统梳理。相同的融合方式归为一类,便于理解它们在架构层面的共性与差异。
3.1 逐层残差相加(residual add):FLUX ControlNet
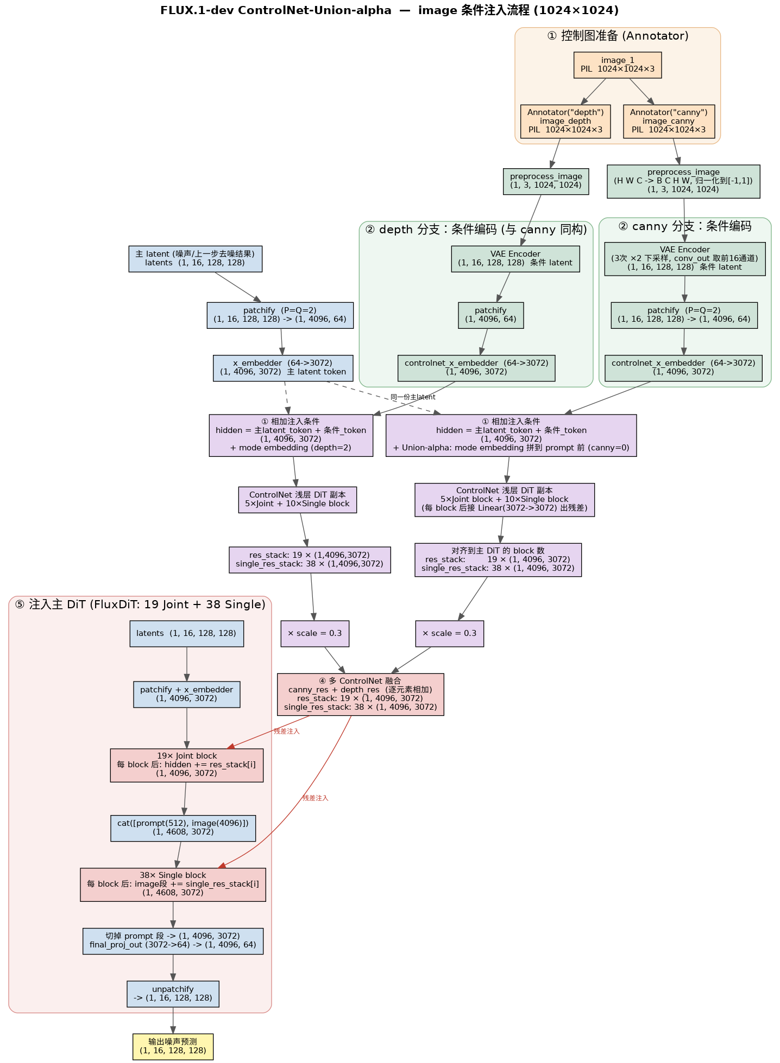
核心抽象:控制图经 VAE 编码为与主 latent 同形状的 token,再通过一个额外训练的控制分支 DiT 副本产生逐层残差,以 hidden += scale * residual 的形式注入主网络。
图像条件编码:
- 输入图像先经过 Annotator(canny、depth、pose、分割等)得到控制图;
- 控制图经 VAE Encoder 编码为条件 latent,形状与主 latent 一致(如
(1, 16, 128, 128)); - 通过
patchify(P=Q=2)切分为(1, 4096, 64)的 token,再经controlnet_x_embedder映射到 3072 维; - 加入
mode embedding区分 depth/canny/pose 等控制类型,实现 Union 多条件共享。
注入/融合方式:
- 控制分支是一个轻量版 DiT 副本(如 5×Joint + 10×Single block),结构与主 DiT 对齐;
- 前向输出
res_stack(19 层)与single_res_stack(38 层); - 在 Joint Block 后:
hidden += res_stack[i]; - 在 Single Block 后:
image 段 += single_res_stack[i]; - 多个控制分支按元素相加后统一乘以
scale(如 0.3)调节强度。
关键设计:
- 冻结主 DiT,仅训练控制分支:保护预训练生成能力,降低训练成本。
- Zero init / 小 scale:输出层零初始化,训练初期不影响主 DiT;推理时通过 scale 平滑调节控制强度。
- Union 多条件:同一网络通过 mode embedding 支持多种控制类型。
3.2 交叉注意力(cross attention):FLUX IP-Adapter
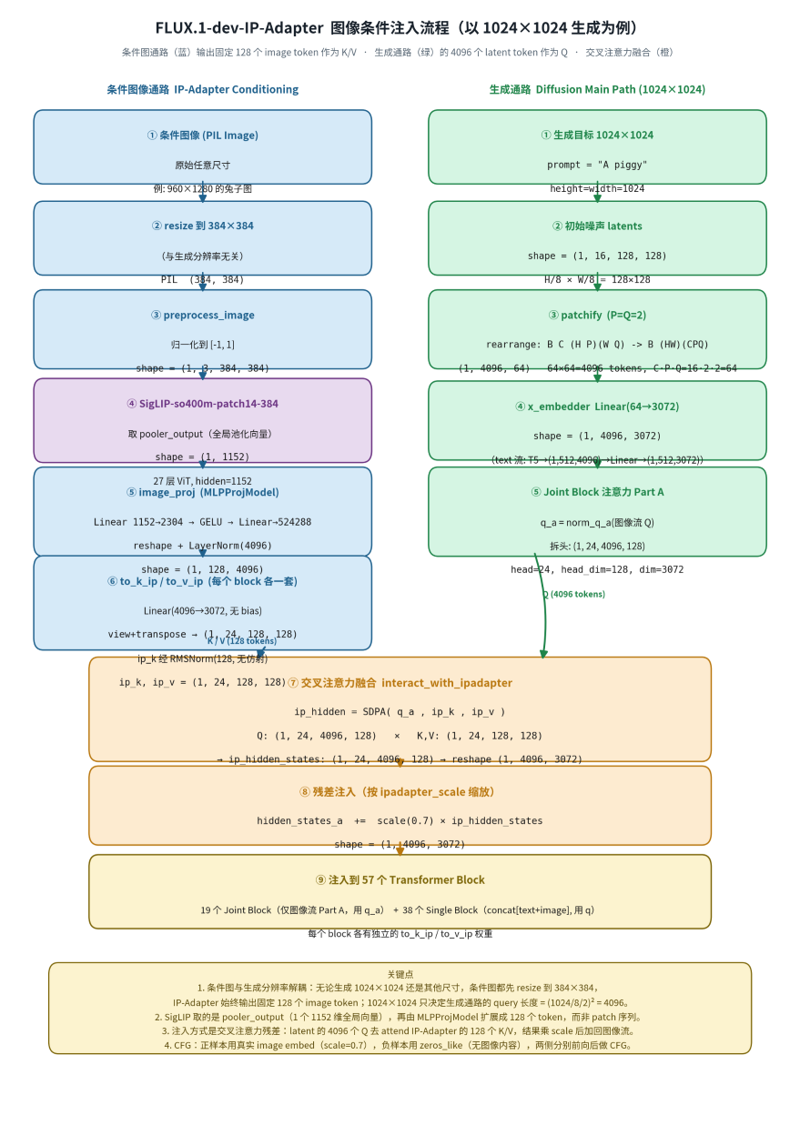
核心抽象:参考图经 CLIP 编码为图像语义 token,再投影为 K/V,与生成路径的 Q 做交叉注意力,将风格/主体信息轻量地注入主 DiT。
图像条件编码:
- 参考图 resize 到固定尺寸(224×224 或 336×336),归一化到
[-1, 1]; - 经 CLIP 图像编码器(如
openai/clip-vit-large-patch14)提取图像特征; - 经 MLP (
image_proj) 扩展为若干 image token(如 128 个),每个与 DiT 维度对齐; - 最终通过可训练的
to_k_ip / to_v_ip投影为注意力用的 K、V,形状(B, heads, N_ip, head_dim)。
注入/融合方式:
- 噪声 latent patchify 后得到 4096 个 token,作为 Query;
- 在每个 Joint Block 的图像流 Part A 中,用生成路径的 Q attend IP-Adapter 的 K/V:
1
ip_hidden = SDPA(q_a, ip_k, ip_v) ip_hidden_statesreshape 回(1, 4096, 3072)后,按ipadapter_scale(如 0.7)残差注入:1
hidden_states_a += scale * ip_hidden_states
关键设计:
- 不改动主 DiT 权重,仅新增少量 K/V 投影,训练成本低。
- CFG 处理:正样本用真实 image embed,负样本用
zeros_like。 - 适合风格迁移、角色一致、主体驱动生成,控制粒度偏“语义/风格”而非“像素级空间”。
| 维度 | ControlNet | IP-Adapter |
|---|---|---|
| 输入 | 控制图(边缘/深度/姿态等) | 参考图(风格/主体/内容) |
| 编码器 | 小型 DiT 副本 + VAE | CLIP 图像编码器 + MLP |
| 注入方式 | 逐层残差相加 | 交叉注意力 K/V 注入 |
| 网络改动 | 新增完整控制分支 | 仅新增少量 K/V 投影 |
| 训练成本 | 较高 | 较低 |
3.3 Channel 拼接(channel concat):FLUX Fill
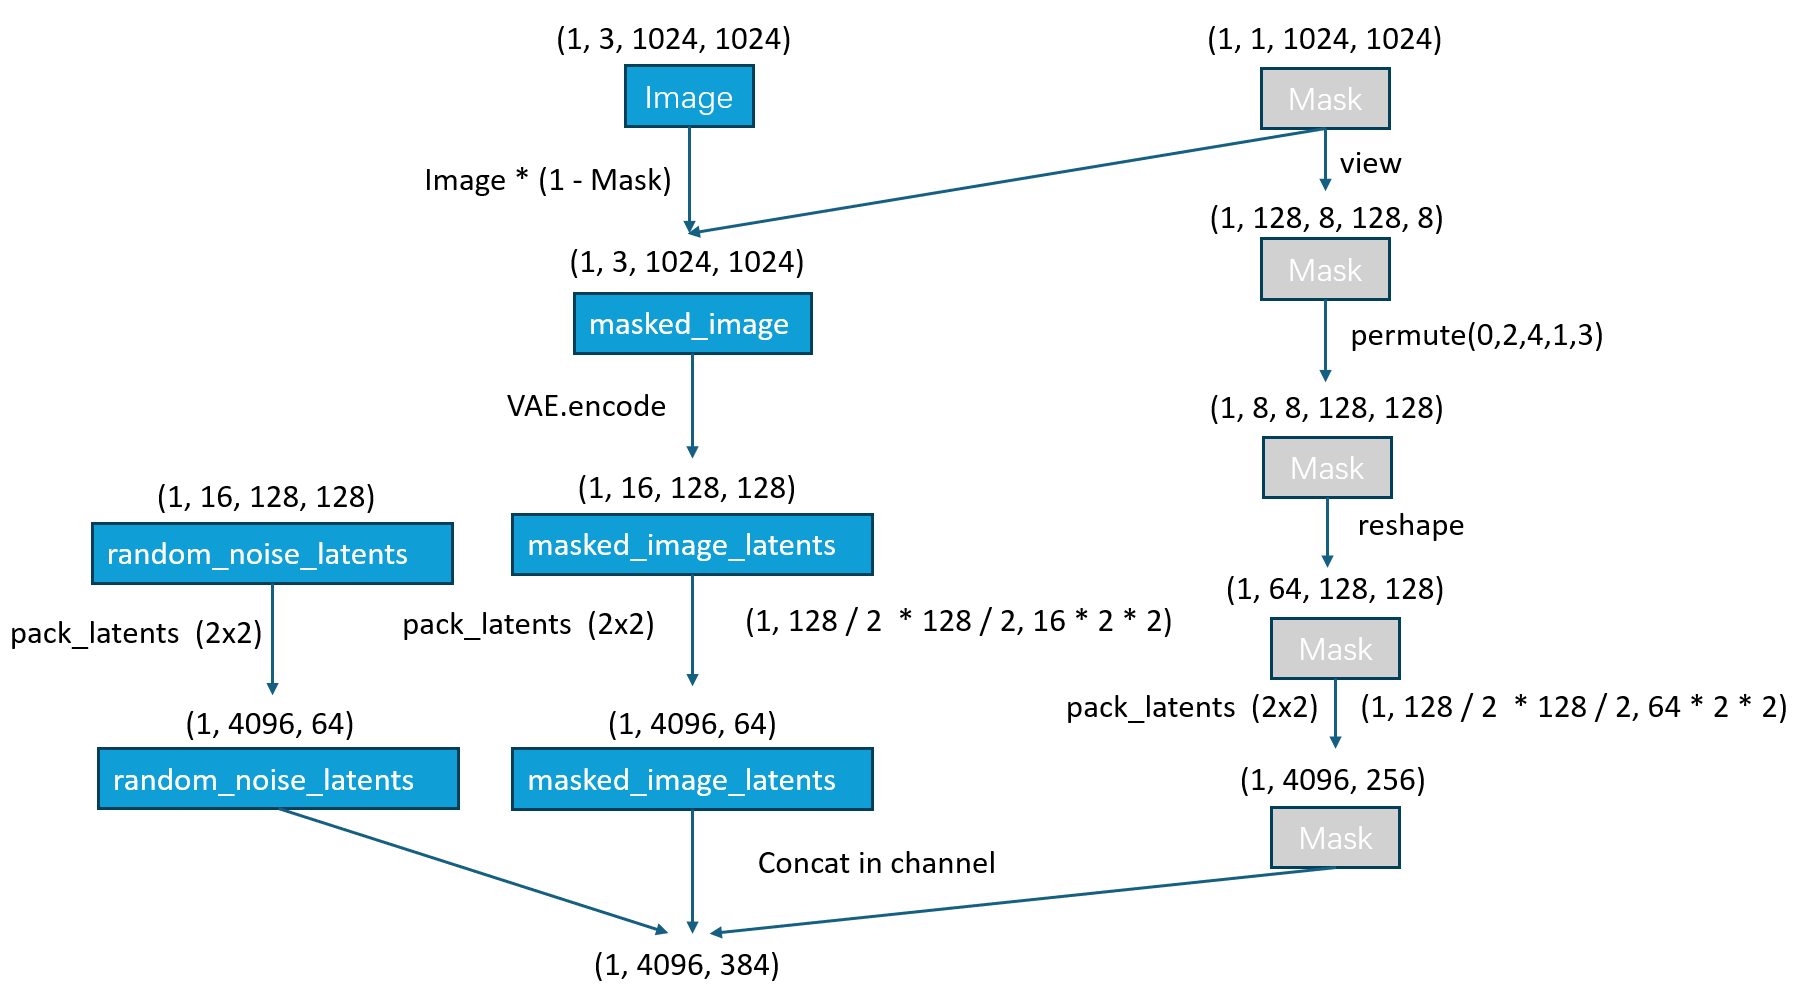
核心抽象:将被 mask 的原图与 mask 本身在 channel 维度拼接到噪声 latent 上,让 DiT 在输入层同时感知“噪声、原图内容、需要修改的区域”。
图像条件编码:
masked_image:原图Image与 mask 相乘得到 masked_image,再经 VAE 编码为masked_image_latents;mask token:mask 经 view/permute/reshape 与pack_latents(2×2)后,变成与 latent token 对齐的 mask token,形状(1, 4096, 256)。
注入/融合方式:
- 将
random_noise_latents(64 维)、masked_image_latents(64 维)、mask token(256 维)在 channel 维度拼接; - 得到
(1, 4096, 384)的向量作为 DiT 输入; - 模型学会在 mask 区域内生成、mask 区域外保持原图内容。
关键设计:
- 直接扩展输入通道数,无需改变 Transformer block 结构;
- 广泛应用于 inpainting / outpainting ControlNet 与模型;
- 需要显式 mask 标注。
3.4 Token 拼接(token concat)
Token concat 是目前最主流的条件注入范式之一:将图像条件编码为与噪声 latent 同质的 token,在序列维度与噪声 token 拼接,通过 timestep、位置编码或模态标识区分身份。与 3.3 节的 channel concat 相比,token concat 不增加输入通道数,而是增加序列长度,让参考图与噪声图在所有 Transformer 层中通过自注意力全局交互。
根据“图像条件编码”的不同,token concat 路线可分为三类:纯 VAE latent token、语义 token(SigLIP/SigLIP2)+ VAE latent token、以及 VLM 语义 token + VAE latent token。下面四小节分别介绍。
3.4.1 图像 VAE 编码 → token concat:OminiControl / HiFi-Inpaint / FLUX Kontext
核心抽象:参考图/原图经 VAE 压缩为图像 latent token,与噪声 latent token 在序列维度拼接,利用自注意力实现“参考图与噪声图全局交互”。
共有流程:
- 噪声 latent:
random_noise_latents经pack_latents(2×2)后形状(1, 4096, 64); - 图像 latent:
image_latents同样 pack 后形状(1, 4096, 64); - 两者在序列维度拼接为
(1, 8192, 64); - 图像 token 通常设置
t=0(干净图),噪声 token 设置随机t,通过 timestep/位置编码区分。
代表方法对比:
| 方法 | 编码细节 | 注入/融合细节 | 特点 |
|---|---|---|---|
| OminiControl | 图像 VAE 编码 | 参考图 latent 与噪声 latent 在序列维度拼接 | 结构最简洁,适合主体驱动生成、风格迁移 |
| HiFi-Inpaint | 图像 VAE 编码 + 高频提取 | token concat + 双流共享增强注意力 | 额外保留高频细节,强调修复区域与原图无缝融合 |
| FLUX Kontext | 图像 VAE 编码 | 原图 token 与噪声 token 拼接,通过 T=0/1 位置编码区分 |
指令式图像编辑,无需 mask |
以 OminiControl 为例,其条件注入流程如下图所示:
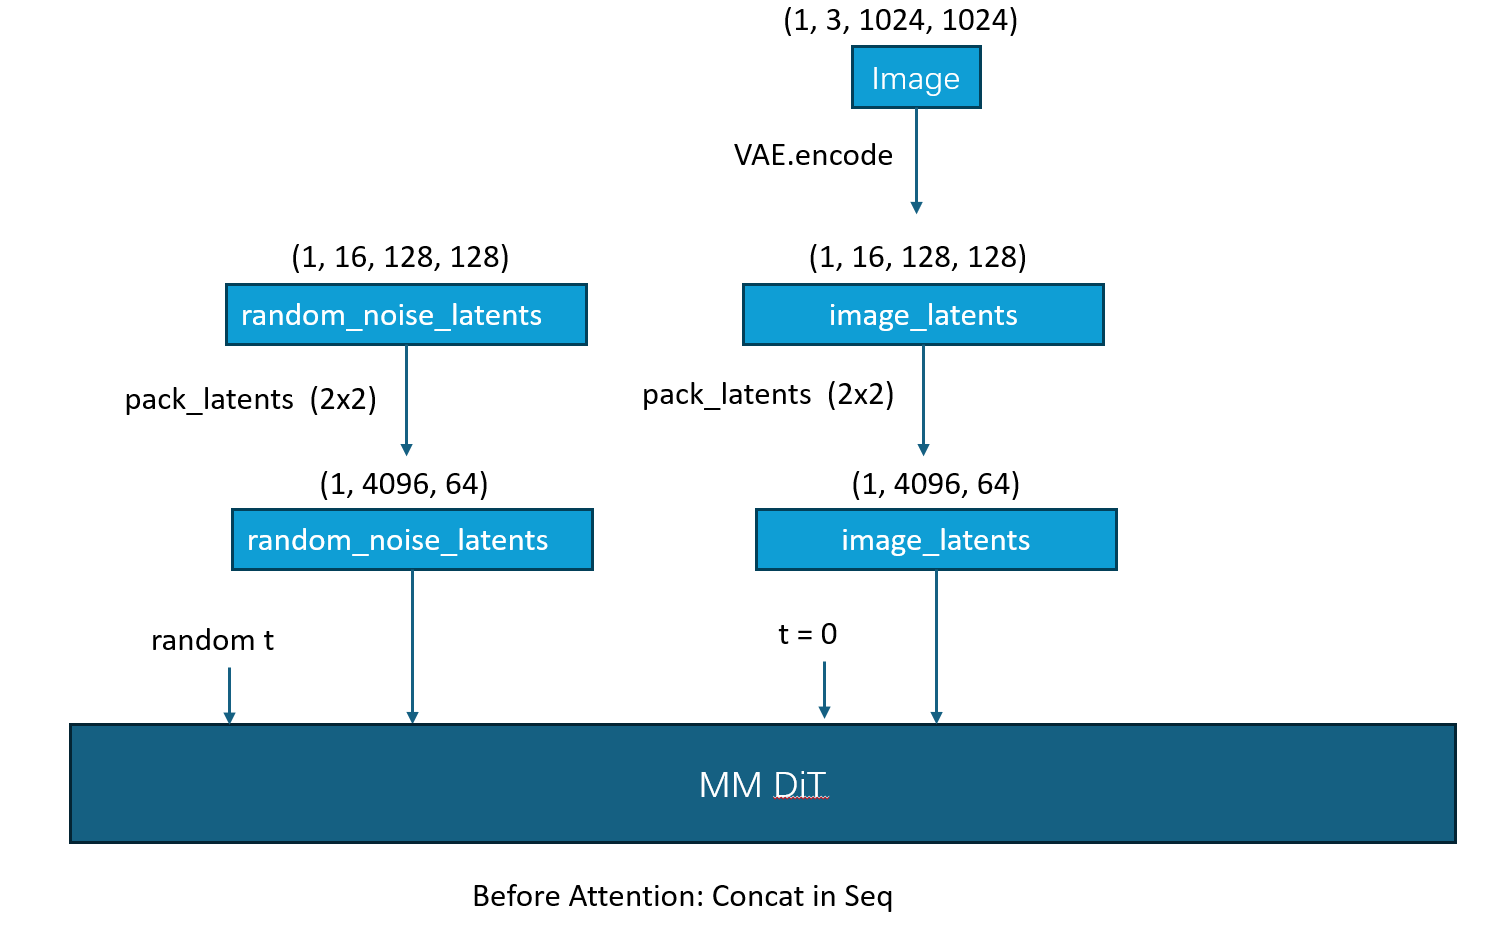
- 输入参考图
Image(形状(1, 3, 1024, 1024))经 VAE 编码得到image_latents(1, 16, 128, 128); - 随机噪声
random_noise_latents与image_latents分别通过pack_latents(2×2)展平为(1, 4096, 64)的 token; - 参考图 token 设置
t = 0(表示干净图),噪声 token 设置随机t,在序列维度拼接后送入 MM DiT; - 自注意力层中,噪声 token 与参考图 token 全局交互,从而把参考图的布局、风格或主体信息引入生成过程。
以 FLUX Kontext 为例:
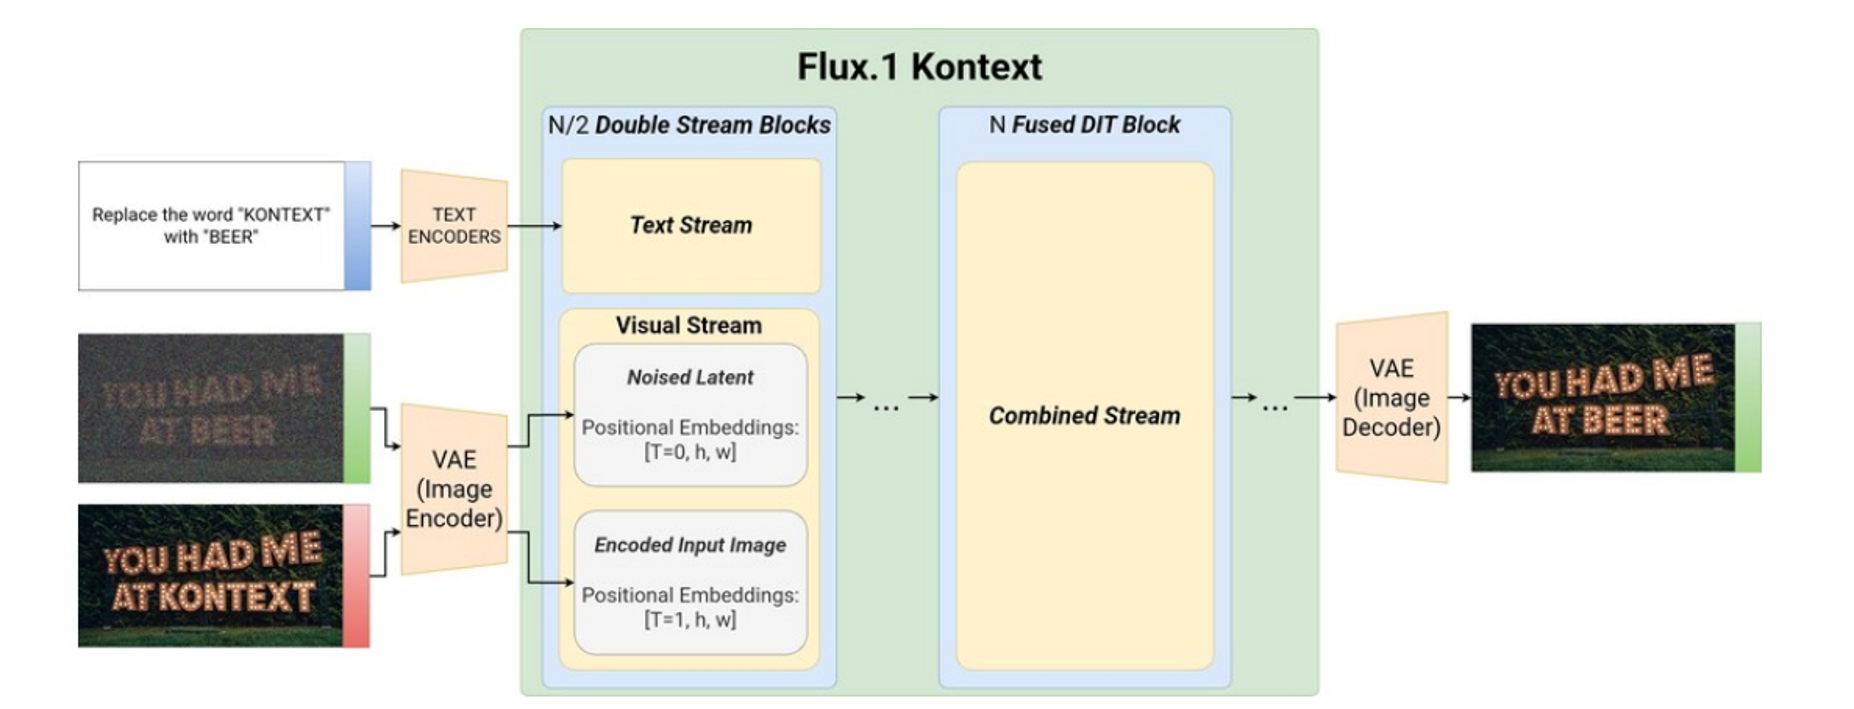
- 输入:文本 prompt + 原图(VAE 编码)+ 随机噪声 latent;
- 位置编码:原图 token 用
T=0,噪声 token 用T=1,文本有独立 Text Stream; - 结构:前半段
N/2 Double Stream Blocks分别处理 Text Stream 和 Visual Stream,后半段N Fused DiT Block合并为 Combined Stream; - 本质:把“原图”当上下文条件,把“编辑指令”当文本条件,在统一自注意力框架下完成编辑。
3.4.2 Diptych + Channel Concat + Token Concat:Insert Anything
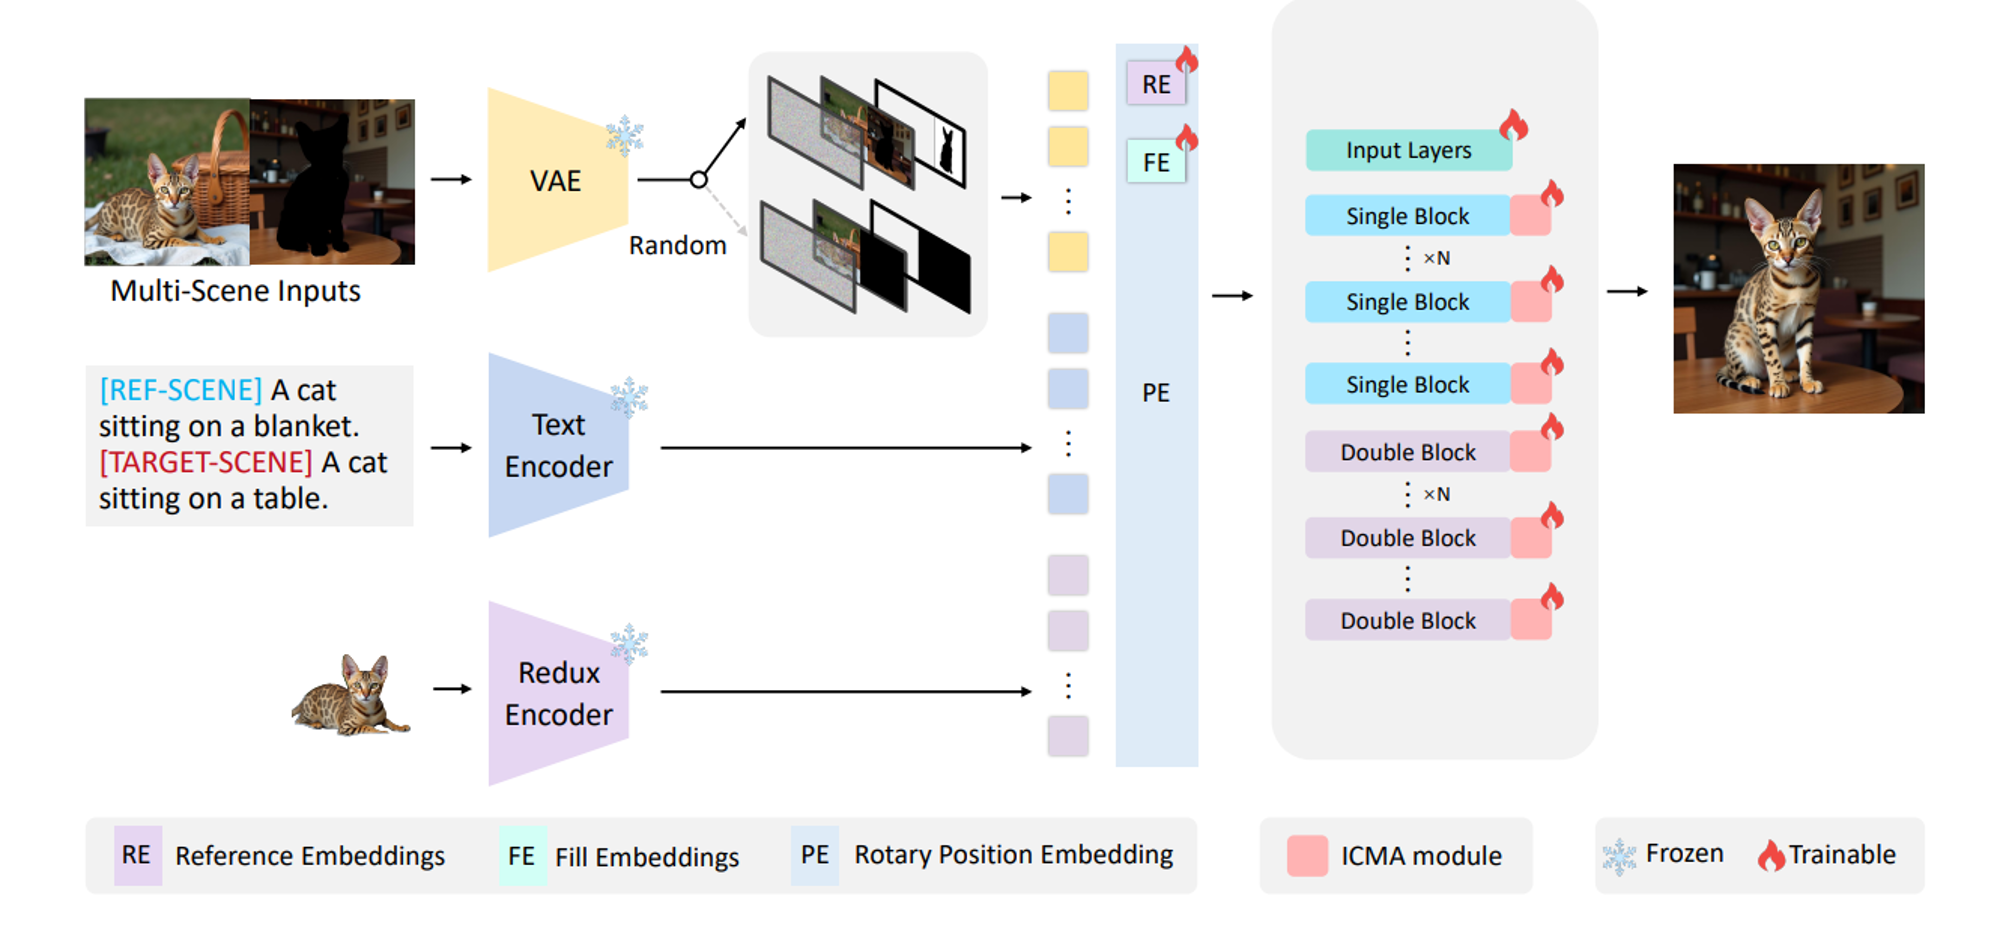
核心抽象:Insert Anything 把“参考图”与“被 mask 的目标场景图”在像素空间按宽度拼接成 diptych(双联画),再同时走两条条件路径:
- VAE 编码 → channel concat:双联画经 VAE 编码后像 FLUX Fill 一样在 channel 维度拼到噪声 latent 上,提供像素级结构与位置信息;
- SigLIP 编码 → token concat:参考图单独经 SigLIP(Redux Encoder)编码为语义 token,像 FLUX Redux 一样在序列维度与噪声 token 拼接,提供高层语义与物体身份。
图像条件编码:
- 参考图(Reference Image):
- 经 VAE 编码,参与 diptych 的构建;
- 同时经 SigLIP / Redux Encoder 压缩为少量语义 token(Reference Embeddings, RE),作为“参考记忆”。
- 目标场景图(Masked Image):
- 原场景图与 mask 相乘得到
masked_image; - 与参考图按宽度拼接成 diptych;
- 整个 diptych 经 VAE 编码为 latent,再与噪声 latent、mask token 在 channel 维度拼接(FLUX Fill 方式)。
- 原场景图与 mask 相乘得到
注入/融合方式:
-
Diptych(双联画)构造:
- 输入:参考图 + 被 mask 的目标场景图;
- 按宽度方向拼接为一张宽图,使参考物体与待填充区域在像素空间相邻;
- 这种构造本身也是一种数据/位置先验,让模型更容易建立参考物体与目标区域的对应关系。
-
Channel Concat(FLUX Fill 路线):
- diptych 经 VAE 得到 diptych latent;
- 与
random_noise_latents(64 维)、mask token(256 维)在 channel 维度拼接; - 作为 DiT 的输入通道,直接告诉模型“目标区域应该生成什么、背景如何保持”。
-
Token Concat(FLUX Redux 路线):
- 参考图单独经 SigLIP 编码为 RE;
- RE 与文本 token、噪声 token 在序列维度拼接;
- 通过自注意力让噪声 token attend 到参考图的语义信息,实现“任意物体插入任意场景”。
训练策略:
- 冻结 VAE、Text Encoder、SigLIP;
- 训练 Input Layers、可训练的图像条件交互模块(如 ICMA)以及部分 Single/Double Block。
关键设计:
- 三重融合:diptych 提供空间布局先验,channel concat 提供像素级条件,token concat 提供高层语义;
- SigLIP 语义对齐:Redux Encoder 把参考图压缩为少量语义 token,决定“插入什么物体”;
- FLUX Fill 式 channel concat:决定“插入到哪里、如何与背景融合”;
- 适合物体插入、场景合成、主体驱动的图像编辑。
3.4.3 SigLIP2 + 图像 VAE 编码 → token concat:Z-Image-Edit
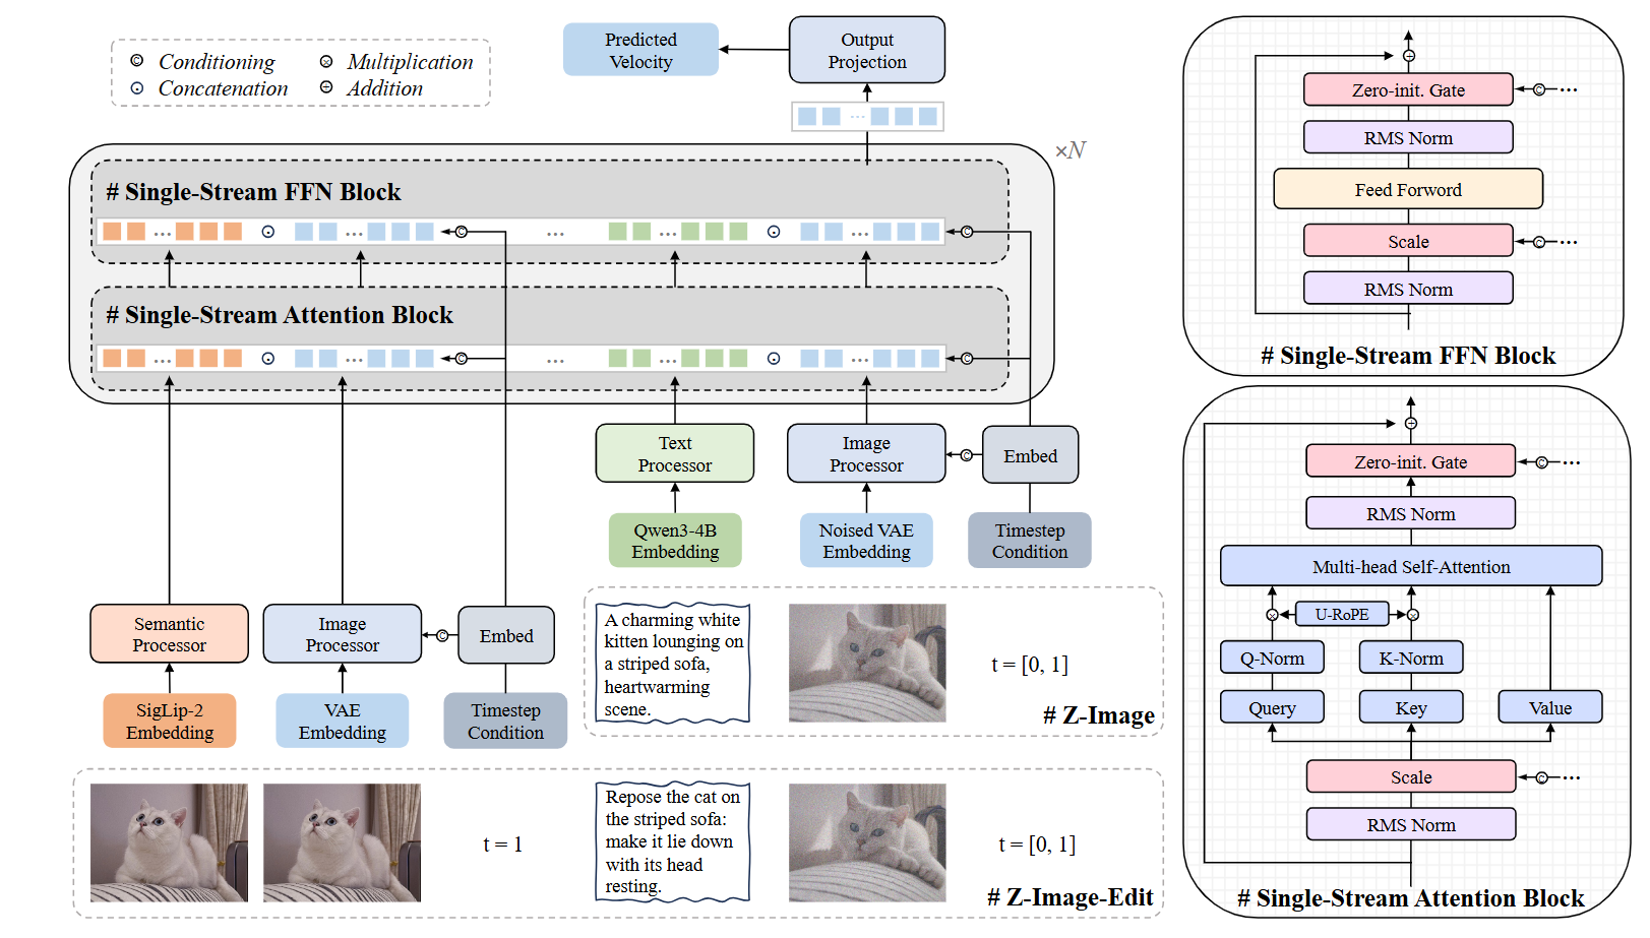
核心抽象:同时引入“语义 token”和“latent token”两种图像表达,与文本 token、噪声 token 一起序列拼接,统一送入 Single-Stream Transformer。
图像条件编码:
- 文本经 LLM 得到语义 token;
- 图像经 SigLIP2 得到图像语义 token;
- 同一张图像经 VAE 压缩得到图像 latent token。
注入/融合方式:
- SigLIP2 语义 token、VAE latent token、文本 token、噪声 token 在序列维度 token concat;
- timestep condition 作为全局条件;
- 每个 block 引入 Zero-init Gate,训练初期让新增模块不影响预训练 DiT。
特点:
- 同时利用 SigLIP2 的语义理解能力和 VAE latent 的像素级信息;
- 支持
t=[0,1]连续时间步,既能做图像生成也能做图像编辑; - 统一了“文生图”和“图生图/编辑”两条路径。
3.4.4 VLM 编码 + 图像 VAE 编码 → token concat:Qwen-Image-Edit / Longcat / JoyAI / Boogu
核心抽象:用多模态大模型(VLM/MLLM)将用户指令和输入图编码为高层语义 token,再与输入图/目标图的 VAE latent token、噪声 token 序列拼接,实现“理解”与“生成”的统一。
以 Qwen-Image-Edit 为例:
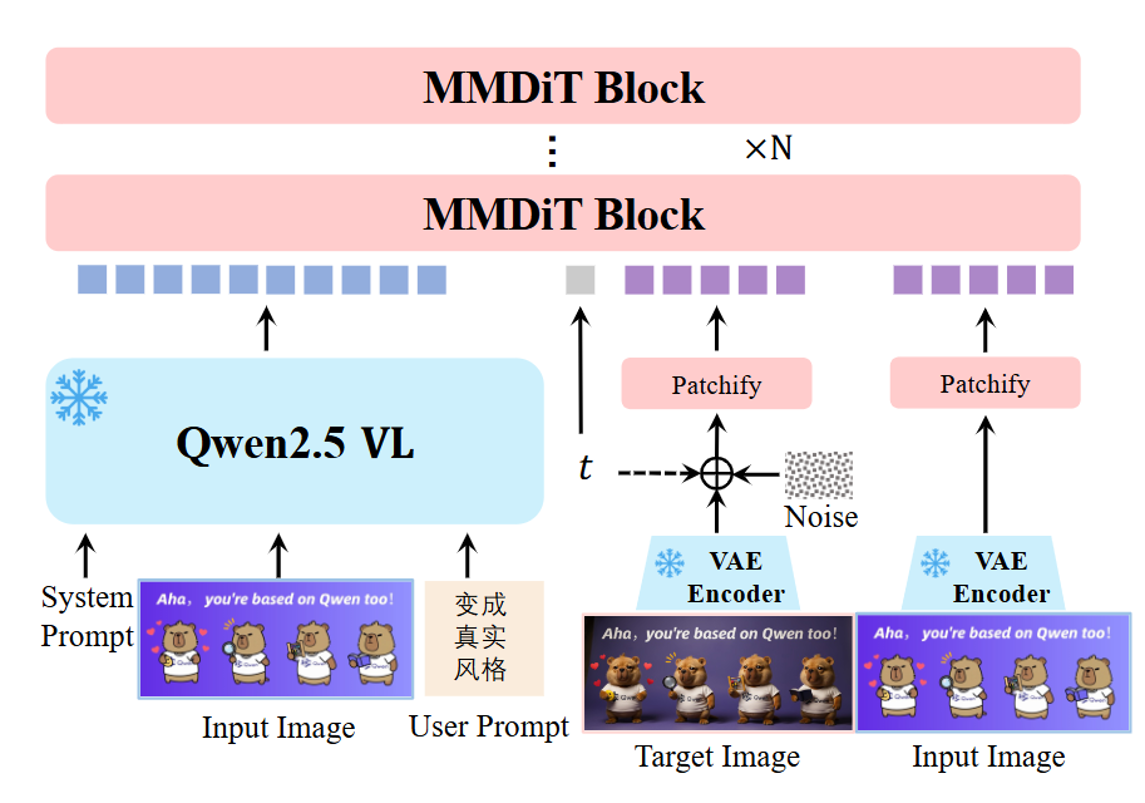
- 用 Qwen2.5 VL 作为 VLM 理解/指令编码器,把用户指令和输入图编码为高层语义 token;
- 输入图和目标图分别经 VAE Encoder 压缩为图像 latent token;
- VLM 语义 token、输入图 token、带噪声目标图 token 在序列维度 token concat,并通过 M-RoPE 统一位置编码;
- 后续接
MM-DiT Blocks × 10与Single-DiT Blocks × 20。
以 Longcat-Image-Edit 为例:
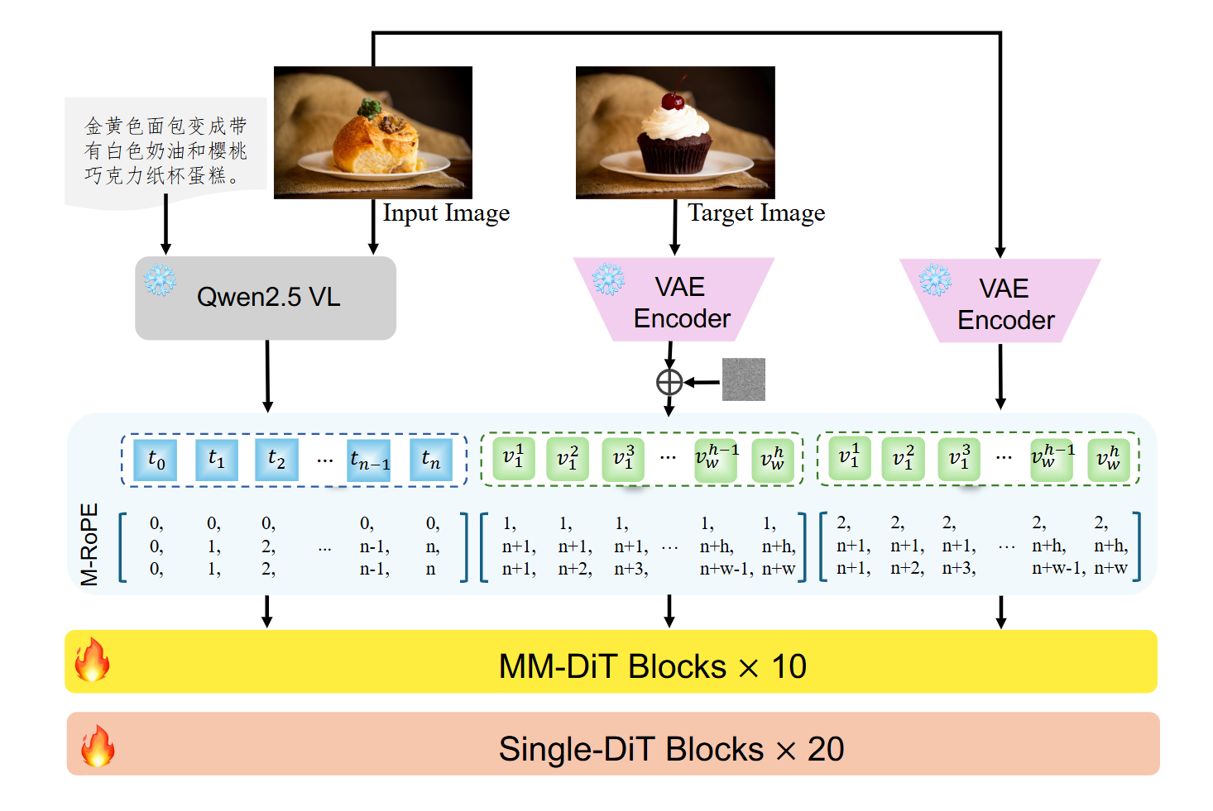
- 输入图与文本编辑指令一起送入 Qwen2.5 VL,得到理解/指令 token
t₀ … tₙ; - 输入图与目标图分别经 VAE Encoder 编码为图像 latent token,其中目标图 latent 再叠加噪声;
- 三类 token 在序列维度拼接:文本理解 token(蓝)、输入图视觉 token(绿)、带噪目标图视觉 token(绿);
- 通过 M-RoPE 统一位置编码:文本 token 置于位置组
0,输入图 token 与目标图 token 分别置于位置组1和2,并在组内保留二维空间坐标(h, w); - 拼接后的序列依次经过
MM-DiT Blocks × 10与Single-DiT Blocks × 20,在自注意力中实现“指令理解—输入图参考—目标图生成”的全局交互。
以 JoyAI Image Edit 为例:
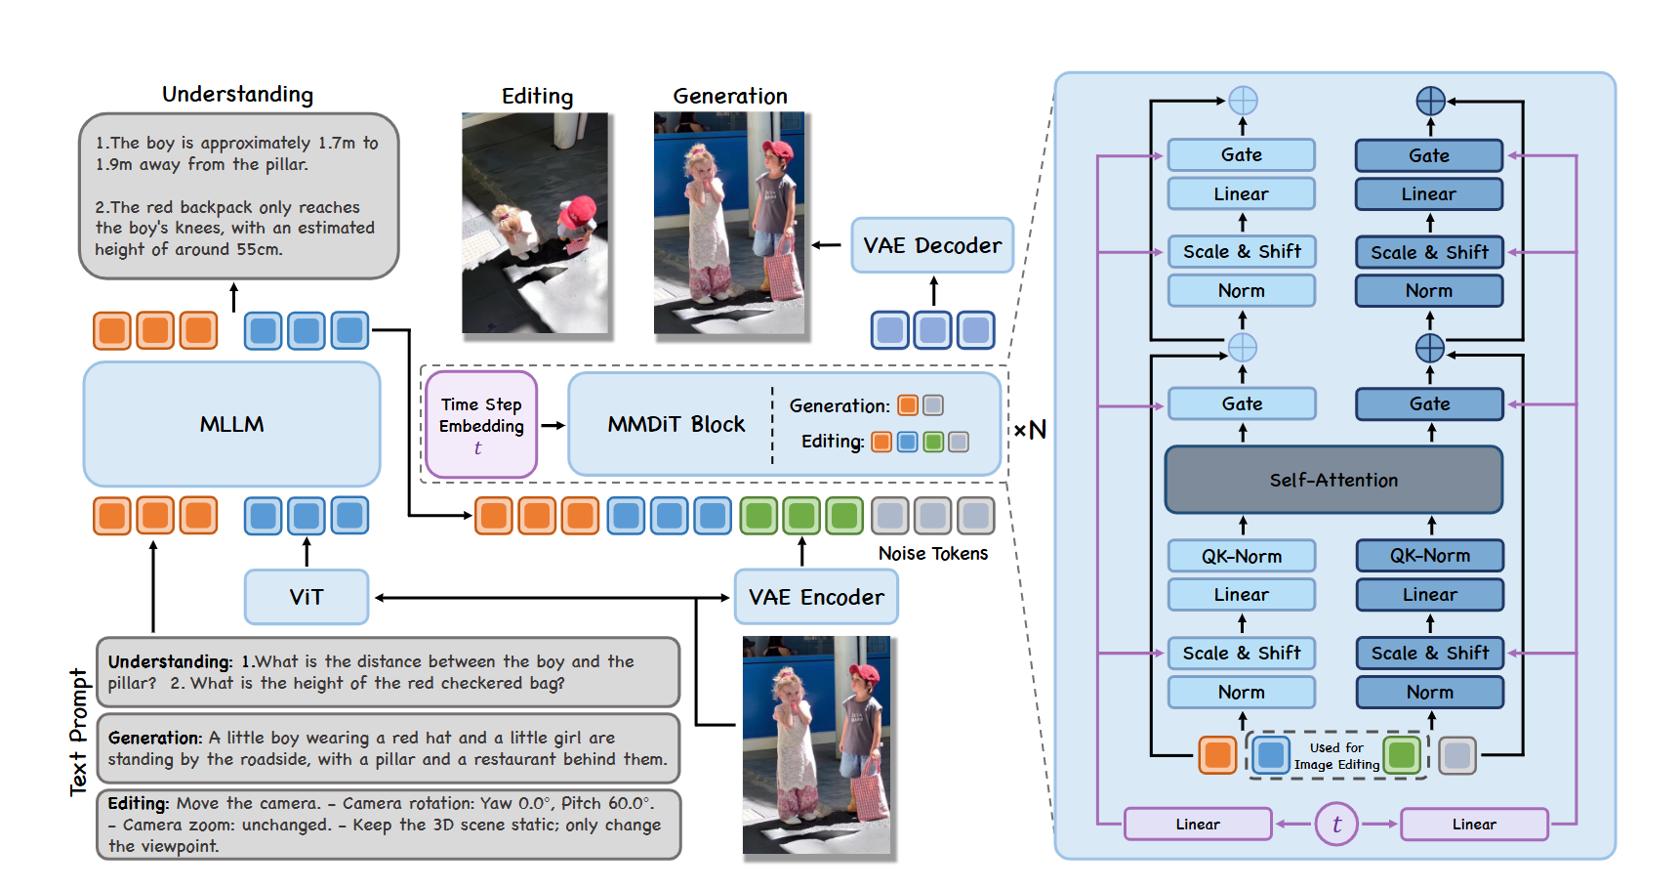
- 一个 MLLM 负责理解输入图像与用户文本指令,输出语义 token;
- 输入图经 ViT 与 VAE Encoder 分别得到视觉 token;
- MLLM 输出与噪声 token、编辑/生成标识一起送入 MMDiT Block;
- 文本/理解 token、图像编辑 token、图像生成 token、噪声 token 通过 Self-Attention 交互;
- timestep embedding 通过 Scale & Shift/Gate 调制各流;
- 不同任务(理解/生成/编辑)共享同一套 block,只在输入序列的 token 类型上区分。
以 Boogu Image Edit 为例:
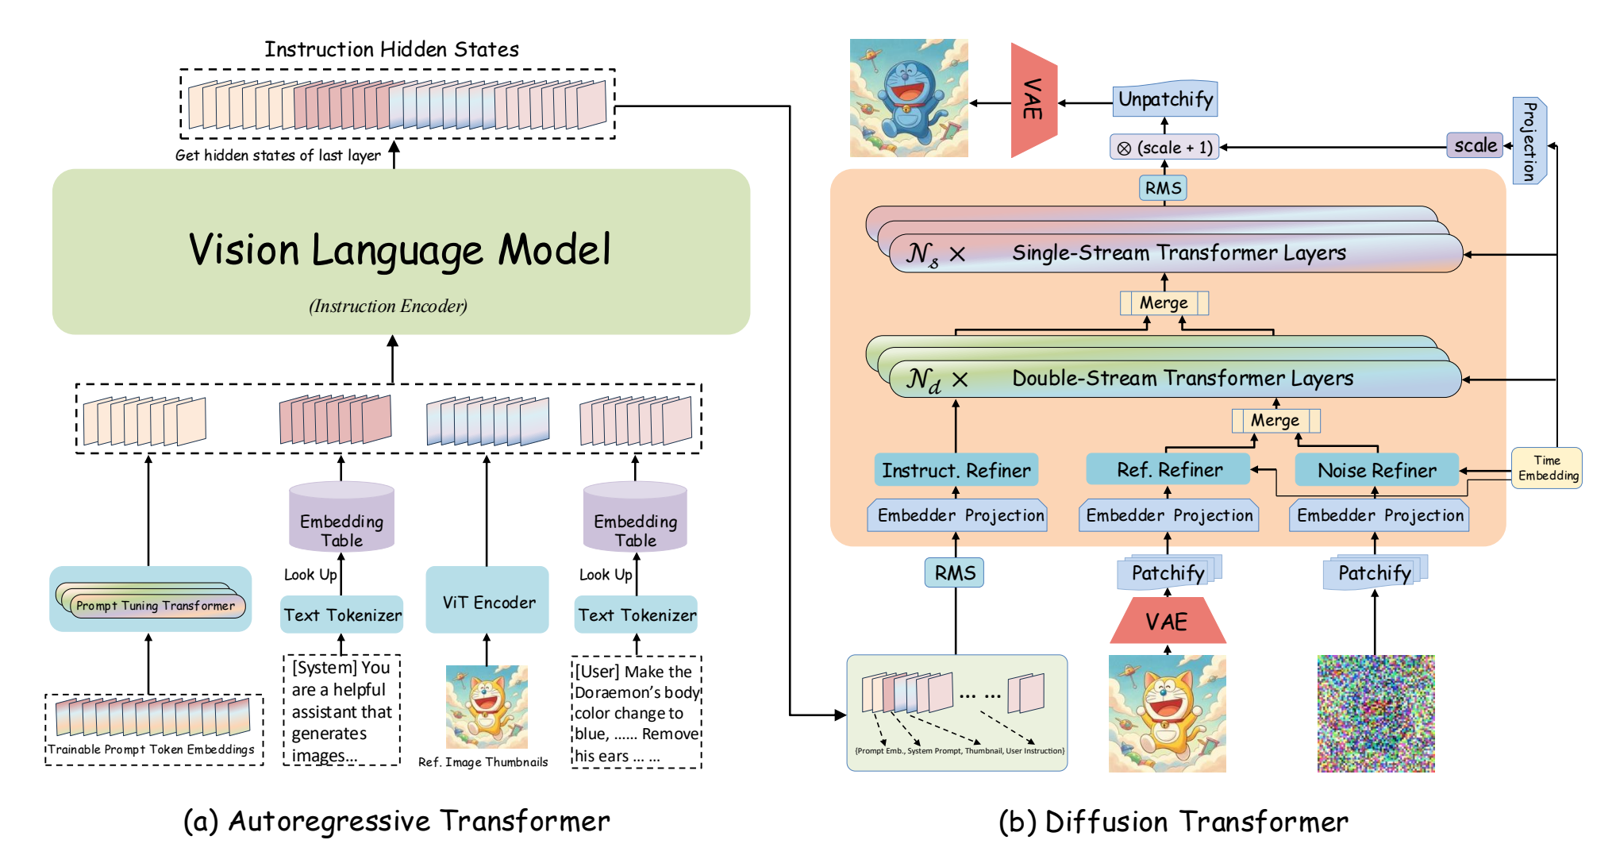
- 左侧 Vision Language Model(Instruction Encoder) 把 system prompt、参考图缩略图、用户指令编码为 instruction hidden states;
- 右侧 Diffusion Transformer 包含:
Nd × Double-Stream Transformer Layers:分别处理 instruction、参考图、噪声三条流;Ns × Single-Stream Transformer Layers:将双流输出 merge 后做全局融合;- 输出经 projection、unpatchify、VAE 解码得到最终图像。
- 三条流在进入 DiT 前分别经过 Embedder Projection + Refiner,让不同模态对齐到同一语义空间。
共同特点:
- 把“理解模型”和“生成模型”拆开又桥接;
- 利用 VLM 的高层语义理解能力处理复杂编辑指令;
- 通过 token concat 将理解结果、参考图、目标噪声图统一纳入 DiT 的自注意力范围。