分布匹配蒸馏
一种将多步扩散模型蒸馏为单步 / 少步生成器的方法系列。
1. 背景与动机
扩散模型(Diffusion Models)能生成高质量图像,但采样需要数十到上百次网络前向计算(迭代去噪),速度慢、成本高。已有的蒸馏方法(Progressive Distillation、Consistency Models、Rectified Flow 等)试图让学生网络逐点拟合教师模型"噪声 → 图像"的确定性映射,这一映射本身极其复杂,学生难以完美模仿,导致蒸馏后质量明显下降。
DMD 系列换了一个思路:不追求复现教师的具体采样轨迹,只要求学生的输出分布在整体上与教师一致(distribution matching)。这类似 GAN 的思想,但用扩散模型来充当"分布的评分器",从而兼得扩散模型训练的稳定性与单步生成的高速度。
2. DMD:单步分布匹配蒸馏
2.1 核心思想
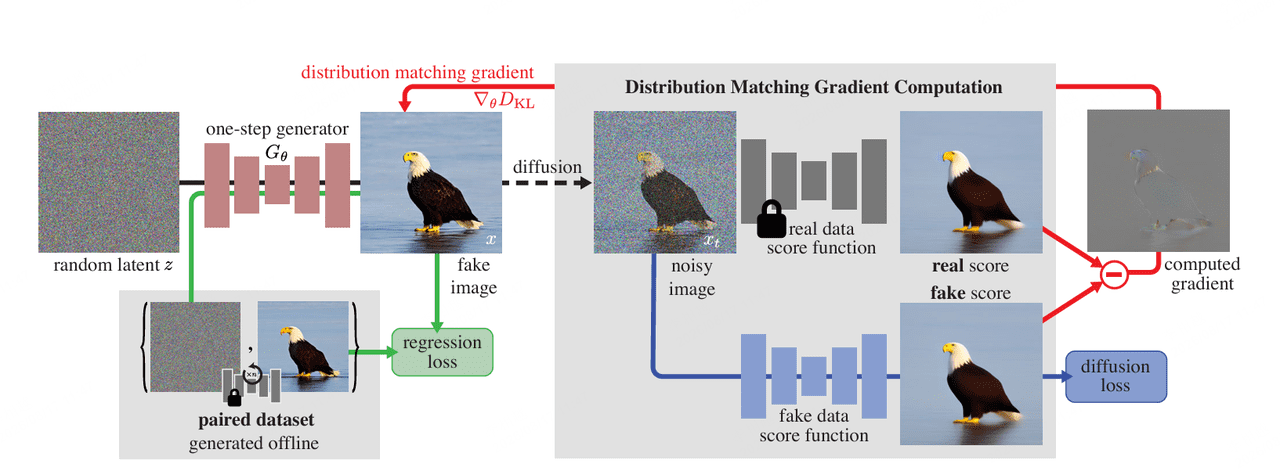
给定一个预训练的多步扩散教师模型 μbase,训练一个单步生成器 Gθ(结构与教师相同、去掉时间条件,用教师权重初始化),使得 Gθ 的输出分布 pfake 与真实数据分布 preal 匹配。目标是最小化 KL 散度:
DKL(pfake∥preal)=Ez∼N(0;I),x=Gθ(z)[−(logpreal(x)−logpfake(x))]
概率密度不可计算,但训练只需要梯度。对 θ 求梯度后:
∇θDKL=E[−(sreal(x)−sfake(x))dθdG]
其中 sreal(x)=∇xlogpreal(x)、sfake(x)=∇xlogpfake(x) 是两个分布的 score 函数。直觉上:
- sreal 把生成样本拉向真实分布的众数(更"真实");
- −sfake 把样本推离当前的生成分布(防止坍缩、更"不假");
- 两者之差就是"更真实、更不假"的更新方向。
2.2 用扩散模型估计两个 score
直接计算 score 有两个障碍:低概率区域 score 发散;且扩散模型只能给出加噪后分布的 score。Score-SDE 理论给出了解法——对样本注入不同强度的随机高斯噪声 xt∼q(xt∣x)∼N(αtx;σt2I),使两个分布"模糊化"后处处重叠,梯度良定义,而扩散模型的去噪输出恰好近似加噪分布的 score:
sreal(xt,t)=−σt2xt−αtμreal(xt,t),sfake(xt,t)=−σt2xt−αtμfakeϕ(xt,t)
- Real score:真实分布固定,直接用冻结的预训练教师 μreal=μbase 建模;
- Fake score:生成分布随训练不断变化,因此用一个动态训练的 fake 扩散模型 μfakeϕ(同样从教师初始化),在生成器输出的 fake 样本上用标准去噪损失持续训练:
Ldenoiseϕ=μfakeϕ(xt,t)−x022
最终的分布匹配梯度(对时间步 t∼U(Tmin,Tmax) 取期望,Tmin=0.02T, Tmax=0.98T):
∇θDKL≃Ez,t,x,xt[wtαt(sfake(xt,t)−sreal(xt,t))dθdG]
权重 wt=αtσt2⋅∥μbase(xt,t)−x∥1CS 用于归一化不同噪声水平下的梯度幅度,稳定训练(比 DreamFusion/ProlificDreamer 的 σt/αt、σt3/αt 加权方案好约 0.9 FID)。
2.3 回归损失(Regression Loss)
纯分布匹配目标在小噪声水平下不可靠,且 score 对概率密度的缩放不敏感,容易模式坍缩(mode collapse)。因此 DMD 额外引入回归损失:
- 离线构造配对数据集 D={z,y}:用教师模型 + 确定性 ODE 求解器(Heun / PNDM,18~256 步)预先生成"噪声-图像"对(成本不到总训练的 1%);
- 强制单步生成器在同一噪声输入下匹配教师输出的大尺度结构:
Lreg=E(z,y)∼Dℓ(Gθ(z),y),ℓ=LPIPS
总目标:生成器优化 DKL+λregLreg(λreg=0.25),fake 评分网络优化 Ldenoiseϕ,两者交替更新。两个损失作用在不同数据流上:KL 用随机噪声生成的 unpaired 样本,回归用配对数据集。
2.4 DMD 训练流程伪代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
| 算法 1:DMD 训练流程
──────────────────────────────────────────────────────
输入:预训练教师扩散模型 μ_real(冻结)
离线配对数据集 D = {(z_ref, y_ref)}(教师多步采样生成)
输出:训练好的单步生成器 G
初始化:
G ← copyWeights(μ_real) # 单步生成器,去掉时间条件
μ_fake ← copyWeights(μ_real) # fake 分布 score 估计网络(可训练)
while 训练未收敛 do
# ---------- 采样 ----------
采样随机噪声批 z ~ N(0, I)
采样配对数据批 (z_ref, y_ref) ~ D
x ← G(z) # 单步生成 fake 图像
x_ref ← G(z_ref)
# ---------- 1) 更新生成器 G ----------
# (a) 分布匹配梯度(对应论文 Eq.7)
t ~ U(T_min, T_max) # 随机时间步
ε ~ N(0, I)
x_t ← α_t · x + σ_t · ε # 对 fake 样本加噪(前向扩散)
with no_grad:
μ_real_pred ← μ_real(x_t, t) # real score:冻结教师
μ_fake_pred ← μ_fake(x_t, t) # fake score:动态网络
w_t ← σ_t²/α_t · 1/mean|μ_real_pred − x| # 梯度归一化权重
grad ← w_t · (μ_fake_pred − μ_real_pred) # score 之差
L_KL ← 0.5 · MSE(x, stopgrad(x − grad)) # 等价地注入该梯度
# (b) 回归损失(对应论文 Eq.9)
L_reg ← LPIPS(x_ref, y_ref)
L_G ← L_KL + λ_reg · L_reg # λ_reg = 0.25
G ← optimizer_G.update(∇L_G)
# ---------- 2) 更新 fake score 网络 μ_fake ----------
t' ~ U(0, 1)
ε' ~ N(0, I)
x_t' ← forwardDiffusion(stopgrad(x), ε', t') # 对最新 fake 样本加噪
L_denoise ← weight(t') · MSE(μ_fake(x_t', t'), stopgrad(x)) # Eq.6
μ_fake ← optimizer_fake.update(∇L_denoise)
end while
|
2.5 结果
| 任务 |
指标 |
备注 |
| ImageNet 64×64 |
FID 2.62(1 步) |
教师 EDM 需 511 步,FID 2.32 |
| CIFAR-10 |
FID 2.66(1 步) |
超越 Consistency Model(6.20)约 2.4× |
| zero-shot COCO-30k(SD v1.5,CFG=3) |
FID 11.49(1 步,90ms) |
教师 50 步 2590ms,FID 8.78 |
| 推理速度 |
20 FPS(FP16,512×512) |
相比教师加速约 30~100× |
3. DMD2:改进的分布匹配蒸馏
3.1 DMD 的痛点与 DMD2 的改进总览
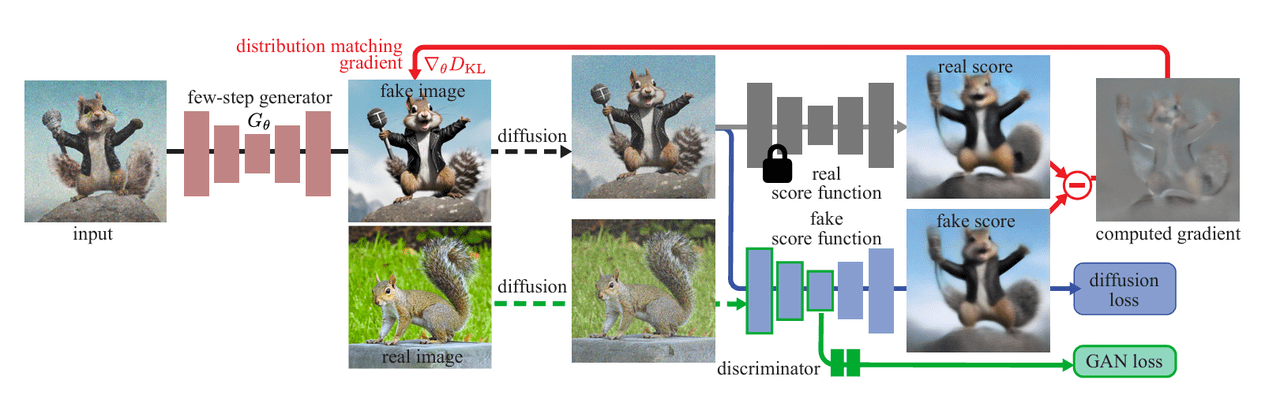
DMD 的回归损失虽然保证了稳定性,但带来两个问题:
- 成本高昂:需要用教师多步采样构造数百万噪声-图像对。以 SDXL 为例,覆盖 LAION 1200 万条 prompt 约需 700 A100 天,是 DMD2 全部训练开销的 4 倍以上;
- 性能天花板:回归损失把学生绑死在教师的采样轨迹上,学生质量无法超越教师。
DMD2 通过三项改进解决这些问题,最终让学生超越教师:
| # |
改进 |
作用 |
| ① |
去除回归损失 + 双时间尺度更新规则(TTUR) |
消除离线建集成本,解开学生与教师轨迹的绑定;用 5:1 的更新频率保证 μ_fake 准确跟踪生成分布,维持训练稳定 |
| ② |
引入 GAN 损失(判别真实图像 vs 生成图像) |
学生首次接触真实数据,纠正教师 real score 的近似误差,使学生质量可超越教师 |
| ③ |
多步生成器 + 反向模拟(Backward Simulation) |
支持 4 步采样提升质量上限;训练时模拟推理时的中间输入分布,消除训练-推理失配 |
3.2 改进①:去除回归损失 + TTUR
直接去掉回归损失会导致训练不稳定(生成图像的平均亮度等统计量剧烈震荡、不收敛)。DMD2 将其归因于:fake 扩散批评器 μfake 在非平稳的生成分布上动态训练,score 估计不准,导致生成器梯度有偏。
借鉴 GAN 训练中的双时间尺度更新规则(Two Time-scale Update Rule, TTUR):每更新 1 次生成器,更新 5 次 μfake,确保 fake score 估计始终准确跟踪当前生成分布。实验表明这样即使不用回归损失也能达到与 DMD 相当的稳定性和质量,且收敛更快。
3.3 改进②:GAN 损失——用真实数据超越教师
DMD 中学生从未见过真实数据,教师 real score 的近似误差会传播给学生且无法纠正。DMD2 在 pipeline 中加入 GAN 目标:
- 判别器设计极简:在 fake 扩散模型 μfake 的 UNet bottleneck 上加一个分类分支,复用其编码特征;
- 对真实图像和生成图像都先注入噪声 F(⋅,t)(平滑分布、稳定训练),再进行真假分类,采用标准 non-saturating GAN 目标:
LGAN=Ex∼preal,t[logD(F(x,t))]+Ez∼pnoise,t[−logD(F(Gθ(z),t))]
判别器在真实数据上训练,不受教师误差限制,因此学生质量得以超越教师。GAN 目标也是分布级的匹配,与 DMD 的哲学一致(无需配对数据、不依赖教师轨迹)。消融显示:单独去掉 GAN 损失,SDXL 蒸馏结果 FID 从 19.32 退化到 26.90,且图像过饱和、过平滑。
3.4 改进③:多步生成器与反向模拟
SDXL 这类大模型单步蒸馏困难(模型容量有限、噪声→高多样性图像的直接映射难学),因此 DMD2 支持多步采样:
- 推理:固定 N 个时间步 {t1,…,tN}(4 步模型用 {999,749,499,249}),从 z0∼N(0,I) 出发,交替执行去噪 x^ti=Gθ(xti,ti) 与加噪 xti+1=αti+1x^ti+σti+1ϵ(借鉴 Consistency Model);
- 训练-推理失配问题:以往多步蒸馏方法训练时输入的是"加噪的真实图像",但推理时(除第一步外)输入的是"上一步生成器输出的加噪结果",两者分布不同,损害质量;
- 反向模拟(Backward Simulation):训练时先用当前学生生成器跑几步、模拟推理过程得到中间样本,再对其去噪并用上述损失监督。由于学生只需跑很少几步,模拟代价可接受;且分布匹配损失不依赖学生的输入,天然不受模拟误差影响(对比同期 Imagine Flash 的回归损失会沿采样路径累积误差)。
3.5 DMD2 训练流程伪代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| 算法 2:DMD2 训练流程
──────────────────────────────────────────────────────
输入:预训练教师扩散模型 μ_real(冻结)
真实图像数据集 D_real(训练 GAN 判别器,无需与 prompt 配对)
多步时间步序列 {t1, ..., tN}(单步时 N=1)
输出:训练好的少步生成器 G
初始化:
G ← copyWeights(μ_real) # 多步生成器(保留时间条件)
μ_fake ← copyWeights(μ_real) # fake score 网络(可训练)
D ← 在 μ_fake 的 UNet bottleneck 上添加分类分支 # GAN 判别器
while 训练未收敛 do
# ---------- 采样:反向模拟推理过程 ----------
采样 z_0 ~ N(0, I),随机选择起始时间步 t_i
x_in ← 加噪后的 z_0(t_i = t1 时)
或用 G 从更早时间步先跑若干步、模拟推理得到 x_{t_i} # Backward Simulation
x ← G(x_in, t_i) # 生成(去噪)输出
# ---------- 1) 更新生成器 G ----------
# (a) 分布匹配梯度(同 DMD,Eq.2)
t ~ U(T_min, T_max),ε ~ N(0, I)
x_t ← α_t · x + σ_t · ε
with no_grad:
s_real ∝ μ_real(x_t, t) # 冻结教师
s_fake ∝ μ_fake(x_t, t)
grad ← w_t · (s_fake − s_real)
L_KL ← 0.5 · MSE(x, stopgrad(x − grad))
# (b) GAN 生成器损失(对生成图像加噪后判真)
t_g ~ U(0, T)
L_GAN_G ← −log D( F(x, t_g) )
L_G ← L_KL + λ_GAN · L_GAN_G # 不再需要回归损失!
G ← optimizer_G.update(∇L_G)
# ---------- 2) 更新 μ_fake 与判别器 D(每 1 次 G 更新对应 5 次,TTUR) ----------
for k = 1 to 5 do
# (a) fake score 去噪损失
t' ~ U(0, 1),ε' ~ N(0, I)
x_t' ← forwardDiffusion(stopgrad(x), ε', t')
L_denoise ← weight(t') · MSE(μ_fake(x_t', t'), stopgrad(x))
# (b) GAN 判别器损失(真实图像 vs 生成图像)
x_real ~ D_real,t_d ~ U(0, T)
L_GAN_D ← −log D(F(x_real, t_d)) − log(1 − D(F(stopgrad(x), t_d)))
L_critic ← L_denoise + L_GAN_D
(μ_fake, D) ← optimizer_critic.update(∇L_critic)
end for
end while
|
3.6 结果
| 任务 |
指标 |
对比 |
| ImageNet 64×64(1 步) |
FID 1.51,加长训练后 1.28 |
超越教师(EDM ODE 采样 511 步,FID 2.32) |
| zero-shot COCO(SD v1.5,1 步) |
FID 8.35 |
比 DMD(11.49)提升 3.14;超越 50 步教师 |
| SDXL 1024×1024(4 步) |
FID 19.32,Patch FID 20.86 |
与 100 步教师(FID 19.36)相当,人评 24% 样本质量优于教师 |
| SDXL(1 步) |
FID 19.01 |
大幅优于 SDXL-Turbo(24.57)、LCM-SDXL(81.62) |
消融实验(ImageNet)验证了各组件的贡献:
| 配置 |
FID |
| DMD 原版(含回归损失) |
2.62 |
| 去掉回归损失 |
3.48(不稳定) |
| 去掉回归损失 + TTUR |
2.61(恢复稳定) |
| 去掉回归损失 + TTUR + GAN(完整 DMD2) |
1.51 |
| 仅用 GAN(无分布匹配) |
2.56 |
4. DMD 与 DMD2 对比总结
| 维度 |
DMD |
DMD2 |
| 核心目标 |
KL 散度分布匹配(双 score 之差) |
同左 + GAN 目标 |
| 回归损失 |
必需(LPIPS,配对数据集) |
去除(真正的分布匹配) |
| 离线数据构造 |
需要教师多步采样生成噪声-图像对(昂贵) |
不需要 |
| 稳定性保障 |
回归损失 |
TTUR(μ_fake 与 G 更新频率 5:1) |
| 是否用真实数据 |
否(学生只见教师输出) |
是(GAN 判别器用真实图像) |
| 采样步数 |
仅 1 步 |
1 步或多步(反向模拟消除训练-推理失配) |
| 质量上限 |
受教师采样轨迹限制 |
可超越教师 |
| 代表成绩 |
ImageNet FID 2.62;COCO FID 11.49 |
ImageNet FID 1.28;COCO FID 8.35;SDXL 4 步媲美教师 |
| 判别器 |
无 |
μ_fake bottleneck 上加分类分支(参数高效) |
一句话总结:DMD 提出"用两个扩散模型的 score 之差作为分布匹配梯度"将多步扩散蒸馏为单步生成器,但依赖离线配对数据的回归损失维稳;DMD2 通过 TTUR 稳定化、GAN 损失引入真实数据监督、反向模拟支持多步采样,去掉了回归损失及其带来的成本与性能天花板,实现了超越教师模型的少步生成。
5. 局限性与后续方向
- DMD:与教师更精细的采样(100/1000 步)仍有轻微质量差距;同时微调 fake score 网络与生成器,显存开销大(可用 LoRA 缓解)。
- DMD2:图像多样性相比教师略有下降;最大规模模型(SDXL)仍需 4 步才能匹配教师质量;训练时 guidance scale 固定,用户灵活性受限;未来可结合人类反馈(RLHF)或奖励模型进一步提升。