位置编码(Position Encoding)详解
本文系统讲解 Transformer 中三类经典位置编码:正余弦位置编码(Sinusoidal PE)、
旋转位置编码(RoPE,实数 / 复数两种实现) 与 三维旋转位置编码(3D RoPE)。
每种编码都从「为什么 → 数学公式 → 完整 PyTorch 代码 → 可视化验证」四个角度展开。
0. 为什么需要位置编码?
自注意力(Self-Attention)的核心计算是:
Attention(Q,K,V)=softmax(dQK⊤)V
它对输入序列是置换不变(permutation-invariant)的:把输入 token 的顺序任意打乱,
注意力输出也只是同样地被打乱,模型本身完全感知不到"谁在前谁在后"。
但语言、图像、视频都有强烈的顺序/空间结构,因此必须显式注入位置信息,这就是位置编码。
常见路线有两大家族:
| 路线 |
做法 |
代表 |
| 加法式(绝对位置) |
给每个位置生成一个向量,加到嵌入上 |
正余弦 PE(原始 Transformer) |
| 乘法式(相对位置) |
用位置对 q/k 做旋转,让内积只依赖相对距离 |
RoPE(LLaMA、Qwen)→ 3D RoPE(CogVideoX、HunyuanVideo) |
下面逐一讲解。
1. 正余弦位置编码(Sinusoidal Position Encoding)
出自《Attention Is All You Need》(Vaswani et al., 2017),是原始 Transformer 的绝对位置编码。
1.1 数学公式
对位置 pos(0, 1, 2, …)和维度下标 i(0 ~ d_model/2),定义:
PE(pos, 2i)=sin(100002i/dmodelpos),PE(pos, 2i+1)=cos(100002i/dmodelpos)
- 偶数维填 sin,奇数维填 cos,正好各占一半;
- 第 i 对维度对应的波长为 2π⋅100002i/dmodel:
低维(i 小)波长短、变化快,捕捉局部位置;高维(i 大)波长可达上万,捕捉全局位置;
- 使用方式极简单——直接加到词嵌入上:x=token_embedding+PE。
相对位置性质:对任意固定偏移 k,PE(pos+k) 是 PE(pos) 的线性函数。
证明只需看一对维度,记 ωi=10000−2i/dmodel,由三角恒等式:
(sin((pos+k)ωi)cos((pos+k)ωi))=只依赖 k 的线性变换(cos(kωi)−sin(kωi)sin(kωi)cos(kωi))(sin(posωi)cos(posωi))
即模型容易从这种编码中学出"相对距离"信息。这个"二维子空间里的旋转"正是后面 RoPE 的灵感来源。
1.2 完整代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
|
"""
正余弦位置编码 (Sinusoidal Position Encoding)
出自《Attention Is All You Need》(Vaswani et al., 2017)。
"""
import torch
import torch.nn as nn
class SinusoidalPositionEncoding(nn.Module):
"""
正余弦位置编码模块(PyTorch 版)。
参数
----
d_model : int
嵌入维度(要求为偶数,这样 sin/cos 正好各占一半)。
max_len : int
预计算的最大序列长度。
"""
def __init__(self, d_model: int, max_len: int = 5000):
super().__init__()
assert d_model % 2 == 0, "d_model 需要为偶数,以便 sin/cos 成对出现"
position = torch.arange(max_len, dtype=torch.float32).unsqueeze(1)
div_term = torch.exp(
torch.arange(0, d_model, 2, dtype=torch.float32)
* (-torch.log(torch.tensor(10000.0)) / d_model)
)
angle = position * div_term
pe = torch.zeros(max_len, d_model)
pe[:, 0::2] = torch.sin(angle)
pe[:, 1::2] = torch.cos(angle)
self.register_buffer("pe", pe, persistent=False)
def forward(self, x: torch.Tensor) -> torch.Tensor:
"""
把位置编码加到输入嵌入上。
参数
----
x : torch.Tensor, shape = (batch, seq_len, d_model)
返回
----
x + PE,形状与输入相同。
"""
seq_len = x.shape[1]
return x + self.pe[:seq_len].to(x.dtype)
if __name__ == "__main__":
torch.manual_seed(42)
max_len, d_model = 100, 64
pos_enc = SinusoidalPositionEncoding(d_model=d_model, max_len=max_len)
print(f"位置编码矩阵形状: {pos_enc.pe.shape}")
batch_size, seq_len = 2, 10
token_emb = torch.randn(batch_size, seq_len, d_model)
x = pos_enc(token_emb)
print(f"加入位置编码后的输入形状: {x.shape}")
pe = pos_enc.pe
print("\n位置 0 的编码(前 8 维):", pe[0, :8].tolist())
print("位置 1 的编码(前 8 维):", [round(v, 4) for v in pe[1, :8].tolist()])
print("\n--- 相对位置性质验证(内积随偏移 k 的变化)---")
for k in [0, 1, 5, 20]:
dots = [round(float(pe[p] @ pe[p + k]), 2) for p in [0, 10, 30, 50]]
print(f"偏移 k={k:2d}: pos=0/10/30/50 处的内积 = {dots}")
|
1.3 可视化
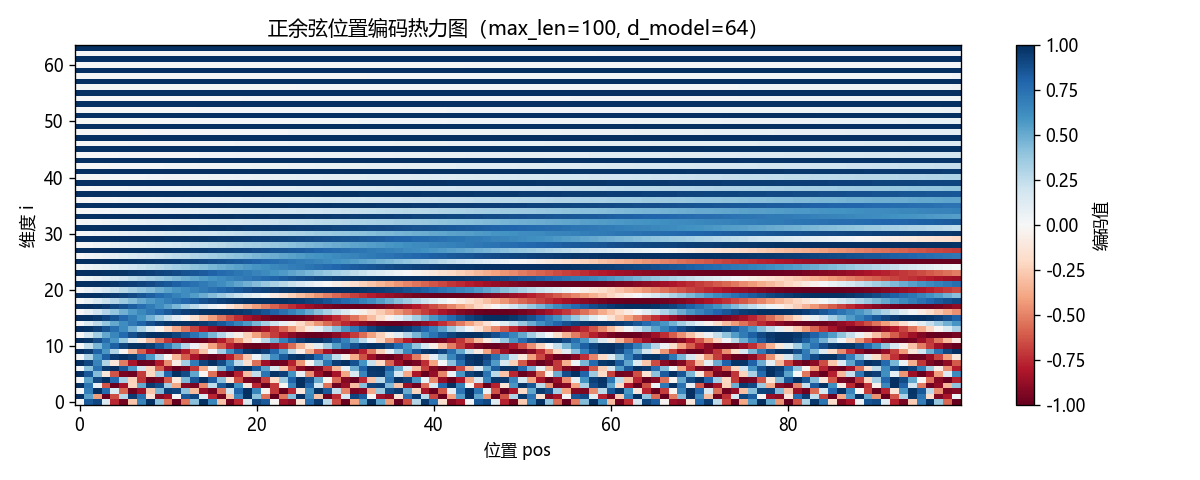
编码矩阵热力图:每一行是一个位置的编码向量。底部(低维)条纹细密(高频),
顶部(高维)几乎是一条直线(低频),直观呈现"多频率"结构。
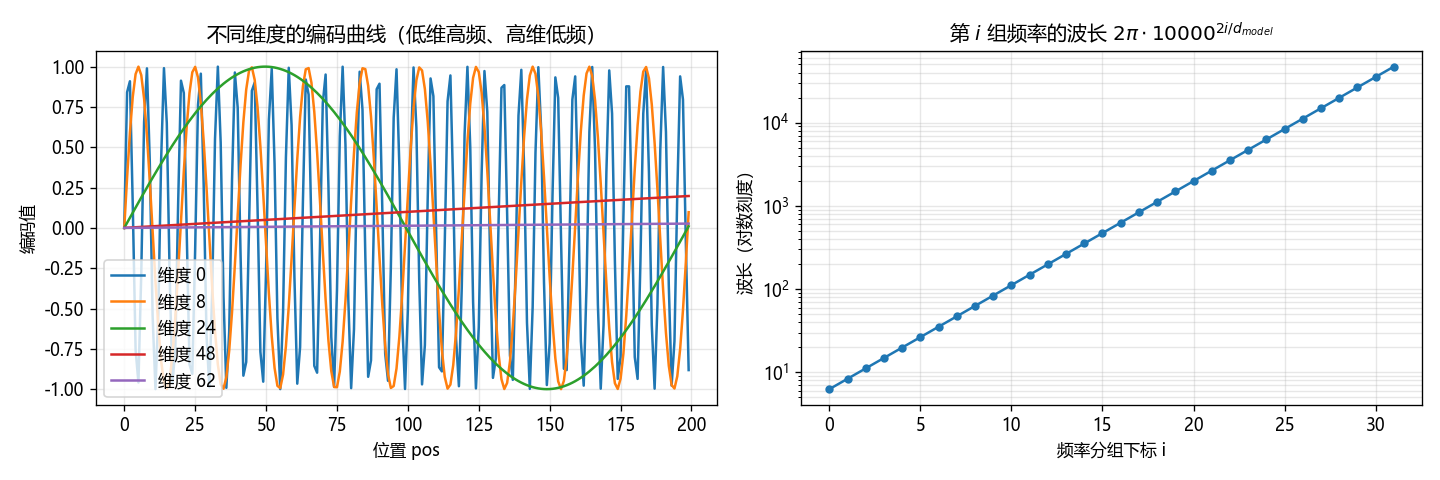
不同维度的曲线与波长分布:左图可见低维(蓝、橙)随位置快速振荡,
高维(红、紫)几乎不动;右图给出各频率分组的波长,按指数从约 2π 增长到 2π·10000。
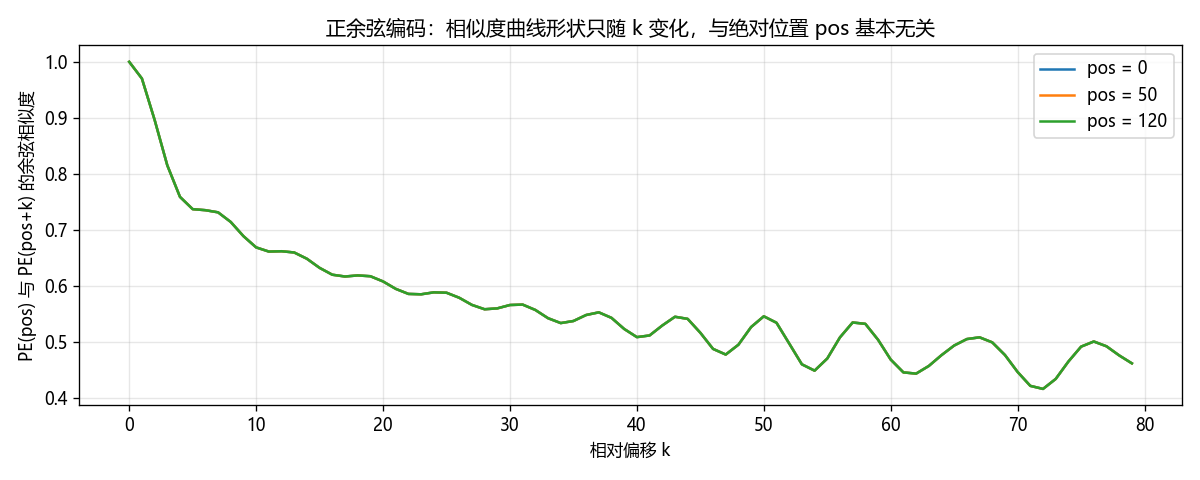
相对位置性质:对三个不同起点 pos = 0 / 50 / 120,画
sim(PE(pos),PE(pos+k)) 随偏移 k 的曲线——三条线几乎完全重合,
说明编码向量的相似度只由相对距离 k 决定,与绝对位置无关。
2. 旋转位置编码 RoPE(实数 rotate_half 实现)
出自《RoFormer: Enhanced Transformer with Rotary Position Embedding》(Su et al., 2021),
被 LLaMA、Qwen、GPT-NeoX 等主流大模型采用,也是视频生成模型中 3D RoPE 的基础。
2.1 数学公式
核心思想:不再把位置向量加到嵌入上,而是把 d 维向量两两分组
(x0,x1),(x2,x3),…,每组看作一个二维向量,对位置 m 处的向量,
第 i 组按角度 mθi 做旋转:
(x2i′x2i+1′)=Ri(m)(cosmθisinmθi−sinmθicosmθi)(x2ix2i+1),θi=10000−2i/d
注意 θi 与正余弦编码用的是同一组频率。整个 d 维旋转矩阵
R(m) 是由 d/2 个 Ri(m) 组成的块对角矩阵。
相对位置性质(RoPE 的灵魂):利用旋转矩阵的性质 R(m)⊤R(n)=R(n−m),
对 query(位置 m)和 key(位置 n)同时旋转后:
⟨RoPE(q,m), RoPE(k,n)⟩=(R(m)q)⊤(R(n)k)=q⊤R(m)⊤R(n)k=q⊤R(n−m)k
内积只依赖相对位置 m−n!注意力分数 QK⊤ 天然携带相对位置信息,
无需任何额外参数——这正是 RoPE 被现代 LLM 广泛采用的根本原因。
实现要点:实际代码不会显式构造稀疏的块对角旋转矩阵,而是展开逐元素恒等式:
x2i′=x2icosmθi−x2i+1sinmθi,x2i+1′=x2isinmθi+x2i+1cosmθi
写成向量形式(即 rotate_half 技巧):
x′=x⊙cos+rotate_half(x)⊙sin,rotate_half([a,b])=[−b,a] (对每个二维分组)
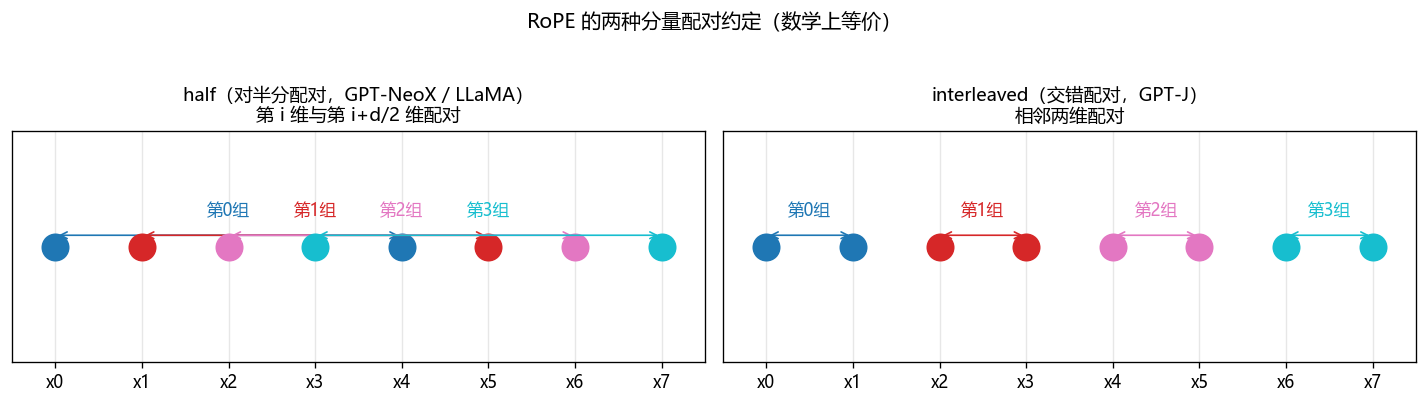
两种配对约定:维度如何两两配对有两种等价惯例——
- 交错配对(GPT-J 风格,
pairing="interleaved"):相邻两维一组 (x0,x1),(x2,x3),…;
- 对半分配对(GPT-NeoX / LLaMA 风格,
pairing="half",默认):前半段与后半段一一配对
(xi,xi+d/2),此时 rotate_half([x1,x2])=[−x2,x1]。
两者数学上完全等价(旋转后内积都只依赖相对位置),只是维度排列不同,
实际模型按其权重布局选用其一,迁移权重时必须对齐约定。
2.2 完整代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
|
"""
旋转位置编码 (Rotary Position Embedding, RoPE) —— 实数 rotate_half 实现
出自《RoFormer: Enhanced Transformer with Rotary Position Embedding》(Su et al., 2021)。
"""
import torch
import torch.nn as nn
class RotaryPositionEmbedding(nn.Module):
"""
RoPE 模块:预计算各位置、各频率的 cos/sin 缓存,forward 时对 q/k 施加旋转。
参数
----
dim : int
每个注意力头的维度 head_dim(要求为偶数)。
max_seq_len : int
预计算的最大序列长度。
base : float
频率基数,论文与 LLaMA 默认 10000。
pairing : str
分量配对约定,"half"(对半分配对,GPT-NeoX / LLaMA 风格,默认)
或 "interleaved"(交错配对,GPT-J 风格)。两者数学上等价。
"""
def __init__(self, dim: int, max_seq_len: int = 2048, base: float = 10000.0,
pairing: str = "half"):
super().__init__()
assert dim % 2 == 0, "head_dim 需要为偶数,以便两两分组旋转"
assert pairing in ("half", "interleaved"), \
f"pairing 只能是 'half' 或 'interleaved',收到 {pairing!r}"
self.pairing = pairing
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
t = torch.arange(max_seq_len).float()
freqs = torch.outer(t, inv_freq)
self.register_buffer("cos_cached", freqs.cos(), persistent=False)
self.register_buffer("sin_cached", freqs.sin(), persistent=False)
def rotate_half(self, x: torch.Tensor) -> torch.Tensor:
"""
对每个二维分组 (a, b) 做 (-b, a),与 cos/sin 配合完成 2D 旋转。
分组方式由 self.pairing 决定:
- "half" : 前半段与后半段配对,[x1, x2] -> [-x2, x1]
- "interleaved" : 相邻两元素配对,(x0,x1), (x2,x3), ...
"""
if self.pairing == "half":
half = x.shape[-1] // 2
x1, x2 = x[..., :half], x[..., half:]
return torch.cat((-x2, x1), dim=-1)
else:
x_pairs = x.reshape(*x.shape[:-1], -1, 2)
a, b = x_pairs[..., 0], x_pairs[..., 1]
out = torch.stack((-b, a), dim=-1)
return out.reshape(*x.shape)
def forward(self, x: torch.Tensor) -> torch.Tensor:
"""
对输入张量施加旋转位置编码。
参数
----
x : torch.Tensor, shape = (batch, heads, seq_len, head_dim)
通常是注意力中的 query 或 key。
返回
----
旋转后的张量,形状与输入相同。
"""
seq_len = x.shape[-2]
cos = self.cos_cached[:seq_len]
sin = self.sin_cached[:seq_len]
if self.pairing == "half":
cos = torch.cat((cos, cos), dim=-1)
sin = torch.cat((sin, sin), dim=-1)
else:
cos = torch.repeat_interleave(cos, repeats=2, dim=-1)
sin = torch.repeat_interleave(sin, repeats=2, dim=-1)
cos = cos[None, None, :, :].to(x.dtype)
sin = sin[None, None, :, :].to(x.dtype)
return x * cos + self.rotate_half(x) * sin
if __name__ == "__main__":
torch.manual_seed(42)
batch, heads, seq_len, head_dim = 2, 4, 16, 64
rope = RotaryPositionEmbedding(dim=head_dim, max_seq_len=512)
q = torch.randn(batch, heads, seq_len, head_dim)
k = torch.randn(batch, heads, seq_len, head_dim)
q_rot = rope(q)
k_rot = rope(k)
print(f"输入 q 形状: {q.shape}, 旋转后 q 形状: {q_rot.shape}")
print("\n--- 相对位置性质验证 ---")
q1 = torch.randn(1, 1, 1, head_dim)
k1 = torch.randn(1, 1, 1, head_dim)
def dot_at(m: int, n: int, pairing: str = "half") -> float:
"""把同一个 q 放在位置 m,同一个 k 放在位置 n,返回二者内积。"""
rope_m = RotaryPositionEmbedding(head_dim, max_seq_len=512, pairing=pairing)
qr = rope_m(q1.expand(1, 1, m + 1, -1))[0, 0, m]
kr = rope_m(k1.expand(1, 1, n + 1, -1))[0, 0, n]
return float(qr @ kr)
for pairing in ("half", "interleaved"):
d1 = dot_at(m=5, n=2, pairing=pairing)
d2 = dot_at(m=100, n=97, pairing=pairing)
d3 = dot_at(m=7, n=2, pairing=pairing)
print(f"[pairing={pairing}]")
print(f" 距离 m-n=3 (m=5, n=2 ): 内积 = {d1:.6f}")
print(f" 距离 m-n=3 (m=100, n=97): 内积 = {d2:.6f} <- 与上面几乎相同")
print(f" 距离 m-n=5 (m=7, n=2 ): 内积 = {d3:.6f} <- 距离不同,内积不同")
print("\n--- 在自注意力中使用 RoPE ---")
d_model, n_heads = 256, 4
head_dim = d_model // n_heads
x = torch.randn(batch, seq_len, d_model)
wq = nn.Linear(d_model, d_model, bias=False)
wk = nn.Linear(d_model, d_model, bias=False)
q = wq(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
k = wk(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
rope = RotaryPositionEmbedding(dim=head_dim, max_seq_len=seq_len)
q, k = rope(q), rope(k)
attn_scores = q @ k.transpose(-2, -1) / (head_dim ** 0.5)
print(f"注意力分数形状: {attn_scores.shape}")
print("完成:注意力分数中已隐式包含相对位置信息。")
|
2.3 可视化
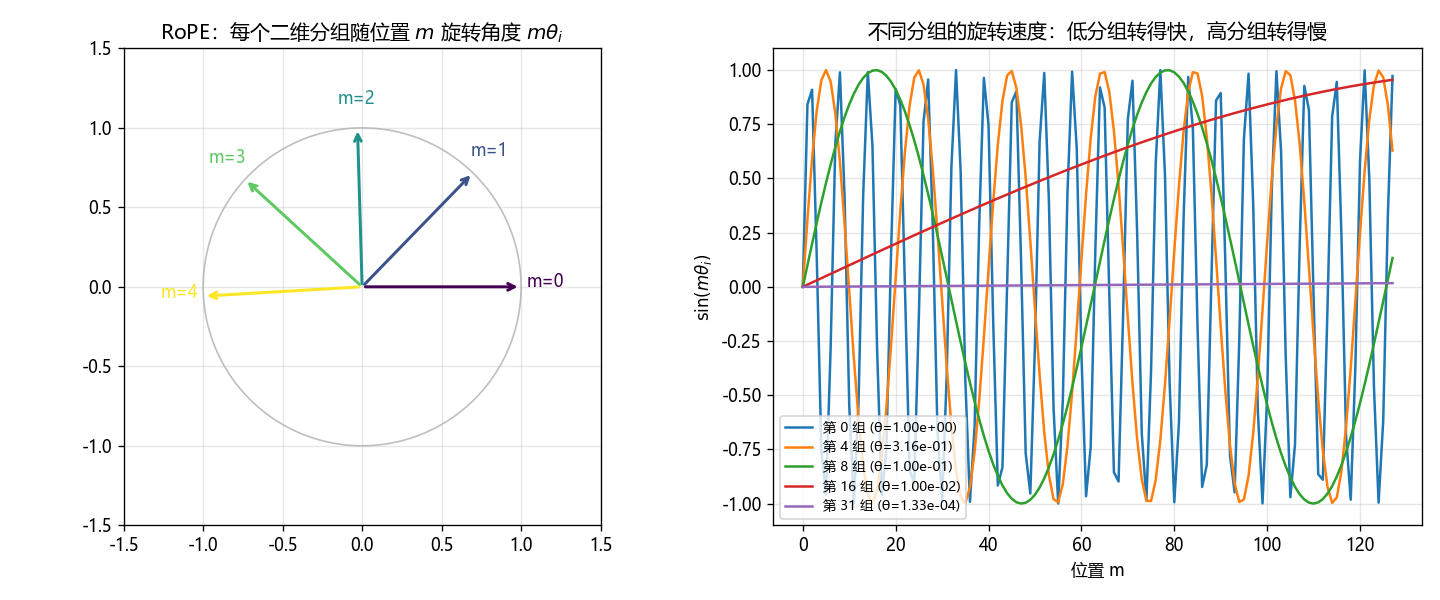
旋转的直观图像:左图把一个二维分组画在单位圆上,位置每加 1,
向量就逆时针转过角度 θi;右图展示不同分组的旋转速度差异——
第 0 组每步转 1 弧度(高频),第 31 组每步只转 10−4 弧度(低频)。
多组频率叠加,使模型既能区分近邻位置,也能表达长距离关系。
两种配对约定:同一组频率,只是维度配对方式不同,数学结果等价。
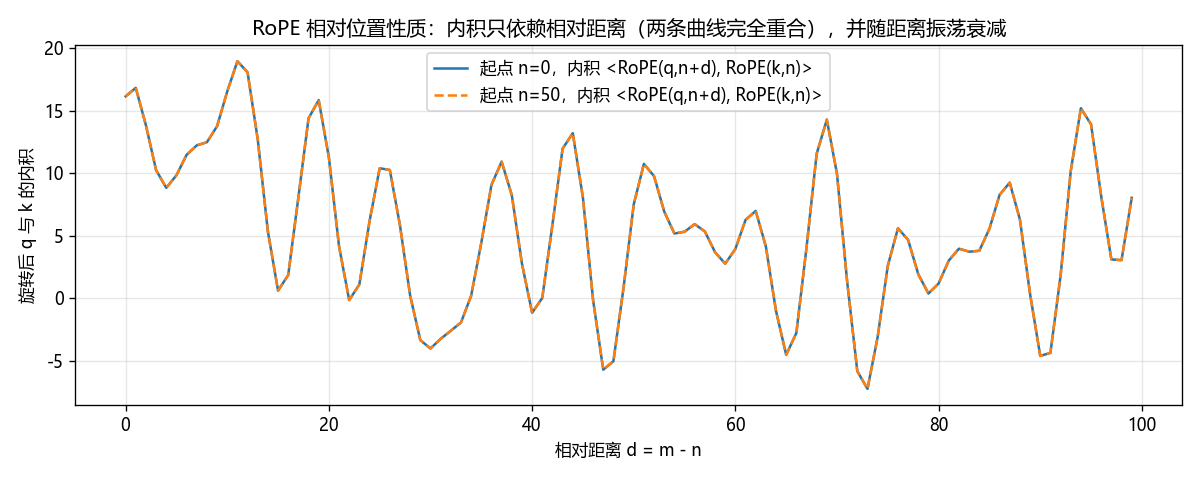
相对位置性质:固定 q、k,分别从起点 n=0 和 n=50 出发,
画 ⟨RoPE(q,n+d), RoPE(k,n)⟩ 随相对距离 d 的曲线——
两条曲线完全重合,数值上验证了内积只依赖 m−n。
同时可见内积随距离振荡衰减,给注意力带来"远距离天然弱化"的归纳偏置。
3. RoPE 的复数实现(LLaMA 官方风格)
3.1 数学公式
二维平面上的旋转恰好就是复数乘法。把每个二维分组看成一个复数
zi=x2i+ix2i+1,则"旋转角度 mθi"等价于乘以单位复数
eimθi:
zi′=zi⋅eimθi
用欧拉公式 eiφ=cosφ+isinφ 展开,
得到的正是第 2 节的实数恒等式,两种写法逐元素等价。
相对位置性质在复数语言下更加一目了然:
⟨RoPE(q,m), RoPE(k,n)⟩=Re[q⋅k⋅ei(m−n)θ]
共轭相乘使角度相减,内积只依赖 m−n。
实现中用到的 PyTorch 复数工具:
| 函数 |
作用 |
torch.polar(abs, angle) |
由模长和辐角构造复数(这里模长恒为 1) |
torch.complex(re, im) |
由实部、虚部两个实数张量构造复数张量 |
torch.view_as_complex(x) |
把 (..., 2) 的实数张量零拷贝视为复数 |
torch.view_as_real(z) |
逆操作,把复数张量视回 (..., 2) 实数 |
3.2 完整代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
|
"""
旋转位置编码 (Rotary Position Embedding, RoPE) —— 复数实现
与实数 rotate_half 实现数学上完全等价,是 LLaMA 官方代码风格。
"""
import torch
import torch.nn as nn
class RotaryPositionEmbeddingComplex(nn.Module):
"""
RoPE 复数实现:预计算每个位置的旋转因子 e^(i·m·θ_i),
forward 时把 q/k 视为复数做逐元素乘法。
参数
----
dim : int
每个注意力头的维度 head_dim(要求为偶数,两两组成一个复数)。
max_seq_len : int
预计算的最大序列长度。
base : float
频率基数,论文与 LLaMA 默认 10000。
pairing : str
分量配对约定,"half"(对半分配对,默认)或 "interleaved"
(交错配对)。两者数学上等价,需与实数实现保持同一约定
才能逐元素对应。
"""
def __init__(self, dim: int, max_seq_len: int = 2048, base: float = 10000.0,
pairing: str = "half"):
super().__init__()
assert dim % 2 == 0, "head_dim 需要为偶数,以便两两组成复数"
assert pairing in ("half", "interleaved"), \
f"pairing 只能是 'half' 或 'interleaved',收到 {pairing!r}"
self.pairing = pairing
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
t = torch.arange(max_seq_len).float()
freqs = torch.outer(t, inv_freq)
freqs_cis = torch.polar(torch.ones_like(freqs), freqs)
self.register_buffer("freqs_cis", freqs_cis, persistent=False)
def forward(self, x: torch.Tensor) -> torch.Tensor:
"""
对输入张量施加旋转位置编码。
参数
----
x : torch.Tensor, shape = (batch, heads, seq_len, head_dim)
通常是注意力中的 query 或 key。
返回
----
旋转后的张量,形状与输入相同。
"""
seq_len = x.shape[-2]
in_dtype = x.dtype
if self.pairing == "half":
half = x.shape[-1] // 2
x_complex = torch.complex(x[..., :half].float(), x[..., half:].float())
else:
x_pairs = x.float().reshape(*x.shape[:-1], -1, 2)
x_complex = torch.view_as_complex(x_pairs)
freqs_cis = self.freqs_cis[:seq_len][None, None, :, :]
x_rotated = x_complex * freqs_cis
if self.pairing == "half":
x_out = torch.cat((x_rotated.real, x_rotated.imag), dim=-1)
else:
x_out = torch.view_as_real(x_rotated).flatten(-2)
return x_out.to(in_dtype)
if __name__ == "__main__":
torch.manual_seed(42)
batch, heads, seq_len, head_dim = 2, 4, 16, 64
rope = RotaryPositionEmbeddingComplex(dim=head_dim, max_seq_len=512)
q = torch.randn(batch, heads, seq_len, head_dim)
k = torch.randn(batch, heads, seq_len, head_dim)
q_rot = rope(q)
k_rot = rope(k)
print(f"输入 q 形状: {q.shape}, 旋转后 q 形状: {q_rot.shape}")
print(f"旋转因子 freqs_cis 形状: {rope.freqs_cis.shape}, "
f"类型: {rope.freqs_cis.dtype}")
print("\n--- 相对位置性质验证 ---")
q1 = torch.randn(1, 1, 1, head_dim)
k1 = torch.randn(1, 1, 1, head_dim)
def dot_at(m: int, n: int, pairing: str = "half") -> float:
"""把同一个 q 放在位置 m,同一个 k 放在位置 n,返回二者内积。"""
rope_m = RotaryPositionEmbeddingComplex(head_dim, max_seq_len=512,
pairing=pairing)
qr = rope_m(q1.expand(1, 1, m + 1, -1))[0, 0, m]
kr = rope_m(k1.expand(1, 1, n + 1, -1))[0, 0, n]
return float(qr @ kr)
for pairing in ("half", "interleaved"):
d1 = dot_at(m=5, n=2, pairing=pairing)
d2 = dot_at(m=100, n=97, pairing=pairing)
d3 = dot_at(m=7, n=2, pairing=pairing)
print(f"[pairing={pairing}]")
print(f" 距离 m-n=3 (m=5, n=2 ): 内积 = {d1:.6f}")
print(f" 距离 m-n=3 (m=100, n=97): 内积 = {d2:.6f} <- 与上面几乎相同")
print(f" 距离 m-n=5 (m=7, n=2 ): 内积 = {d3:.6f} <- 距离不同,内积不同")
print("\n--- 在自注意力中使用 RoPE(复数版)---")
d_model, n_heads = 256, 4
head_dim = d_model // n_heads
x = torch.randn(batch, seq_len, d_model)
wq = nn.Linear(d_model, d_model, bias=False)
wk = nn.Linear(d_model, d_model, bias=False)
q = wq(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
k = wk(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
rope = RotaryPositionEmbeddingComplex(dim=head_dim, max_seq_len=seq_len)
q, k = rope(q), rope(k)
attn_scores = q @ k.transpose(-2, -1) / (head_dim ** 0.5)
print(f"注意力分数形状: {attn_scores.shape}")
print("完成:注意力分数中已隐式包含相对位置信息。")
|
3.3 与实数实现的等价性验证
把第 2 节的 RotaryPositionEmbedding 与本节的 RotaryPositionEmbeddingComplex
两个类复制到同一个文件中,再运行下面的验证代码(无需任何外部模块):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
|
import torch
torch.manual_seed(42)
head_dim = 64
q = torch.randn(2, 4, 16, head_dim)
for pairing in ("half", "interleaved"):
rope_c = RotaryPositionEmbeddingComplex(dim=head_dim, max_seq_len=512,
pairing=pairing)
rope_r = RotaryPositionEmbedding(dim=head_dim, max_seq_len=512,
pairing=pairing)
max_diff = (rope_c(q) - rope_r(q)).abs().max().item()
print(f"[pairing={pairing}] 复数 vs 实数,最大绝对误差: {max_diff:.2e}")
assert max_diff < 1e-5, f"pairing={pairing} 时两种实现结果不一致!"
print("两种实现结果一致(误差在浮点精度范围内)。")
|
运行结果(误差在 float32 精度量级,验证两种实现逐元素等价):
1
2
3
| [pairing=half] 复数 vs 实数,最大绝对误差: 2.38e-07
[pairing=interleaved] 复数 vs 实数,最大绝对误差: 2.38e-07
两种实现结果一致(误差在浮点精度范围内)。
|
4. 三维旋转位置编码(3D RoPE)
4.1 数学公式
1D RoPE 处理的是标量位置 m;而视频 / 3D 体素数据中每个 token 的位置是三元组
p=(t,h,w)(时间帧、空间行、空间列)。CogVideoX、HunyuanVideo 等视频生成模型
使用的正是 3D RoPE。
核心思想:分轴旋转。把 head_dim 切成三段 (dt,dh,dw),每段独立做普通 RoPE,
各自只编码一个坐标轴:
- 前 dt 维:只用 t 坐标的角度旋转;
- 中 dh 维:只用 h 坐标的角度旋转;
- 后 dw 维:只用 w 坐标的角度旋转。
每段内部采用交错配对:相邻两维 (x0,x1),(x2,x3),… 构成二维分组,
按角度 paxis⋅θi 旋转,θi=base−2i/daxis。
相对位置性质:由于旋转按轴分块、逐块正交,query 与 key 的内积分解为三段之和:
⟨RoPE(q,p), RoPE(k,p′)⟩=axis∈{t,h,w}∑qaxis⊤R(Δaxis)kaxis,Δ=p−p′
内积只依赖三维相对位移 Δ=(Δt,Δh,Δw),
与绝对位置无关——1D RoPE 的优良性质在 3D 下完整保留。
4.2 完整代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
|
"""
三维旋转位置编码 (3D Rotary Position Embedding, 3D RoPE)
CogVideoX、HunyuanVideo 等视频生成模型使用的位置编码。
"""
import torch
import torch.nn as nn
class RotaryPositionEmbedding3D(nn.Module):
"""
3D RoPE 模块:对位置为 (t, h, w) 的 token 序列施加分轴旋转。
参数
----
dim : int
每个注意力头的维度 head_dim。
axes_dims : tuple[int, int, int] or None
三个坐标轴各占的维度 (d_t, d_h, d_w),要求均为偶数且和为 dim。
为 None 时均分,此时要求 dim 能被 6 整除(每轴 dim/3 且为偶数)。
max_positions : tuple[int, int, int]
三个坐标轴各自预计算的最大位置 (T, H, W)。
base : float
频率基数,默认 10000。
"""
def __init__(self, dim: int,
axes_dims: tuple = None,
max_positions: tuple = (1024, 128, 128),
base: float = 10000.0):
super().__init__()
if axes_dims is None:
assert dim % 6 == 0, \
"axes_dims 为 None 时要求 dim 能被 6 整除(均分三轴且每轴为偶数)"
axes_dims = (dim // 3, dim // 3, dim // 3)
assert len(axes_dims) == 3 and sum(axes_dims) == dim, \
f"axes_dims 必须为三元组且和等于 dim={dim},收到 {axes_dims}"
assert all(d % 2 == 0 for d in axes_dims), \
f"每个轴的维度都必须为偶数(交错配对旋转),收到 {axes_dims}"
self.dim = dim
self.axes_dims = tuple(axes_dims)
for axis, (d_axis, max_pos) in enumerate(zip(axes_dims, max_positions)):
inv_freq = 1.0 / (base ** (torch.arange(0, d_axis, 2).float() / d_axis))
t = torch.arange(max_pos).float()
freqs = torch.outer(t, inv_freq)
cos = torch.repeat_interleave(freqs.cos(), repeats=2, dim=-1)
sin = torch.repeat_interleave(freqs.sin(), repeats=2, dim=-1)
self.register_buffer(f"cos_cached_{axis}", cos, persistent=False)
self.register_buffer(f"sin_cached_{axis}", sin, persistent=False)
@staticmethod
def rotate_half(x: torch.Tensor) -> torch.Tensor:
"""
交错配对的 rotate_half:相邻两维 (a, b) -> (-b, a)。
"""
x_pairs = x.reshape(*x.shape[:-1], -1, 2)
a, b = x_pairs[..., 0], x_pairs[..., 1]
out = torch.stack((-b, a), dim=-1)
return out.reshape(*x.shape)
@staticmethod
def grid_positions(t: int, h: int, w: int) -> torch.Tensor:
"""
生成规则网格的位置坐标,形状 (t*h*w, 3),按 (t, h, w) 行主序排列,
与视频 patch 序列化(先时间帧、再行、再列)的顺序一致。
"""
return torch.stack(torch.meshgrid(
torch.arange(t), torch.arange(h), torch.arange(w), indexing="ij"
), dim=-1).reshape(-1, 3)
def forward(self, x: torch.Tensor, positions: torch.Tensor) -> torch.Tensor:
"""
对输入张量施加 3D 旋转位置编码。
参数
----
x : torch.Tensor, shape = (batch, heads, seq_len, head_dim)
通常是注意力中的 query 或 key。
positions : torch.Tensor, shape = (seq_len, 3),整数
每个 token 的 (t, h, w) 坐标。可用 grid_positions 生成规则网格,
也可以传入任意坐标(如插值、变分辨率场景)。
返回
----
旋转后的张量,形状与输入相同。
"""
assert positions.shape[-1] == 3 and positions.shape[0] == x.shape[-2], \
f"positions 应为 (seq_len, 3),收到 {tuple(positions.shape)}"
cos_parts, sin_parts = [], []
for axis in range(3):
idx = positions[:, axis].long()
cos_parts.append(getattr(self, f"cos_cached_{axis}")[idx])
sin_parts.append(getattr(self, f"sin_cached_{axis}")[idx])
cos = torch.cat(cos_parts, dim=-1)
sin = torch.cat(sin_parts, dim=-1)
cos = cos[None, None, :, :].to(x.dtype)
sin = sin[None, None, :, :].to(x.dtype)
return x * cos + self.rotate_half(x) * sin
if __name__ == "__main__":
torch.manual_seed(42)
batch, heads, head_dim = 2, 4, 96
T, H, W = 4, 8, 8
seq_len = T * H * W
rope = RotaryPositionEmbedding3D(dim=head_dim, max_positions=(16, 64, 64))
positions = rope.grid_positions(T, H, W)
q = torch.randn(batch, heads, seq_len, head_dim)
k = torch.randn(batch, heads, seq_len, head_dim)
q_rot = rope(q, positions)
k_rot = rope(k, positions)
print(f"输入 q 形状: {q.shape}, 旋转后 q 形状: {q_rot.shape}")
print(f"位置坐标形状: {positions.shape}, 前 3 个坐标:\n{positions[:3]}")
print("\n--- 3D 相对位置性质验证 ---")
q1 = torch.randn(1, 1, 1, head_dim)
k1 = torch.randn(1, 1, 1, head_dim)
def dot_at(p: tuple, p_prime: tuple) -> float:
"""把同一个 q 放在位置 p,同一个 k 放在位置 p',返回二者内积。"""
qr = rope(q1, torch.tensor([p]))[0, 0, 0]
kr = rope(k1, torch.tensor([p_prime]))[0, 0, 0]
return float(qr @ kr)
d1 = dot_at((5, 3, 2), (2, 1, 0))
d2 = dot_at((10, 8, 6), (7, 6, 4))
d3 = dot_at((5, 3, 2), (2, 1, 1))
print(f"Δ=(3,2,2) 位置 (5,3,2)/(2,1,0): 内积 = {d1:.6f}")
print(f"Δ=(3,2,2) 位置 (10,8,6)/(7,6,4): 内积 = {d2:.6f} <- 与上面几乎相同")
print(f"Δ=(3,2,1) 位置 (5,3,2)/(2,1,1): 内积 = {d3:.6f} <- 位移不同,内积不同")
print("\n--- 分轴独立性验证 ---")
d_t = dot_at((4, 0, 0), (1, 0, 0))
d_h = dot_at((0, 4, 0), (0, 1, 0))
d_w = dot_at((0, 0, 4), (0, 0, 1))
print(f"仅时间轴位移 Δt=3: 内积 = {d_t:.6f}")
print(f"仅行轴位移 Δh=3: 内积 = {d_h:.6f}")
print(f"仅列轴位移 Δw=3: 内积 = {d_w:.6f} <- 各轴频率独立,三者一般不同")
print("\n--- 在自注意力中使用 3D RoPE ---")
d_model, n_heads = 384, 4
head_dim = d_model // n_heads
x = torch.randn(batch, seq_len, d_model)
wq = nn.Linear(d_model, d_model, bias=False)
wk = nn.Linear(d_model, d_model, bias=False)
q = wq(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
k = wk(x).view(batch, seq_len, n_heads, head_dim).transpose(1, 2)
rope = RotaryPositionEmbedding3D(dim=head_dim, max_positions=(T, H, W))
q, k = rope(q, positions), rope(k, positions)
attn_scores = q @ k.transpose(-2, -1) / (head_dim ** 0.5)
print(f"注意力分数形状: {attn_scores.shape}")
print("完成:注意力分数中已隐式包含三维相对位置信息。")
|
4.3 可视化
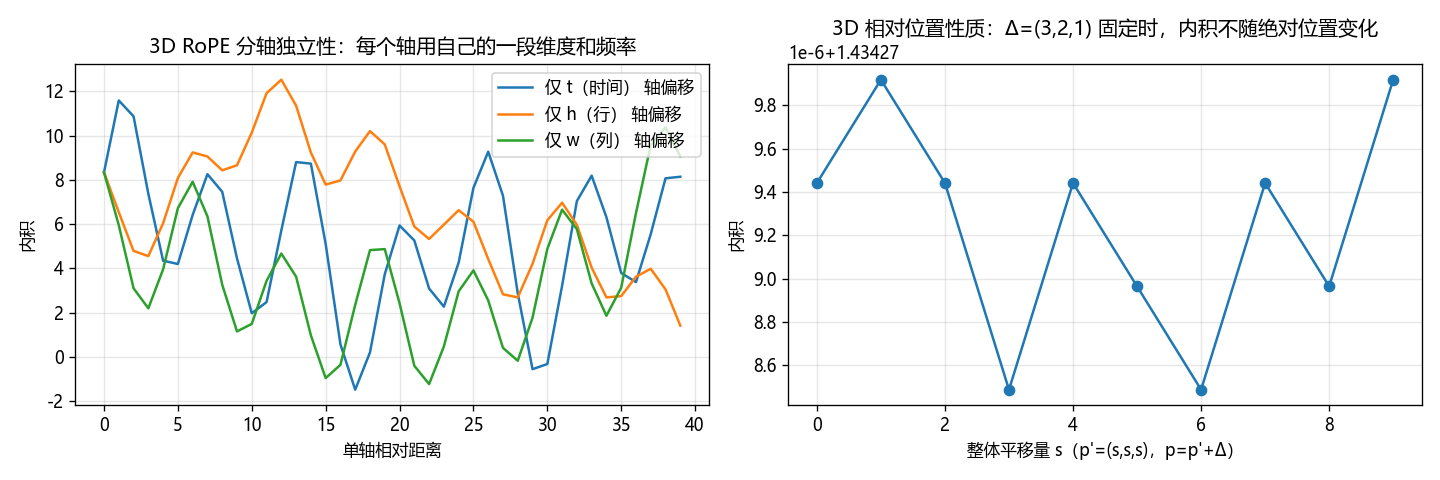
分轴独立性(左图):只沿某一个轴拉开距离时,内积随距离的变化曲线由
该轴独占的那段维度和频率决定,三条曲线互不相同——时间轴、行轴、列轴
各自为政。3D 相对位置性质(右图):固定三维位移 Δ=(3,2,1),
把两个 token 整体平移(p′=(s,s,s),p=p′+Δ),内积的波动仅在
10−6 量级(注意 y 轴的 1e-6 偏移标注),即数值上完全不随绝对位置变化。
5. 正余弦位置编码 vs 旋转位置编码:优劣势分析
前面几节分别给出了两种编码的原理与实现,这一节从工程与理论两个角度系统对比它们的优劣。
5.1 正余弦位置编码的优势
- 零参数、零训练成本:编码完全由公式确定,没有任何需要学习的参数,
不会引入额外的优化负担或过拟合风险。
- 实现极简、即插即用:一次预计算后只是一个加法,完全不侵入注意力结构,
任何 Transformer 变体都可以无改造接入。
- 位置信息全网络可见:编码加在输入嵌入上,随后每一层的 FFN、残差连接、
归一化都能直接"看到"位置信号,不限于注意力路径。
- 行为完全可解释:每个维度就是一条已知频率的 sin/cos 曲线,
编码的几何结构(多频率、相对位置的线性可表性)有严格的数学刻画,便于分析与调试。
5.2 正余弦位置编码的劣势
- 位置信号随深度被稀释:位置只在输入层注入一次,经过多层线性变换与
非线性混合后,深层表示中的位置信息越来越弱——模型越深,这个问题越明显。
- 相对位置是间接的:PE(pos+k) 虽是 PE(pos) 的线性函数,但模型必须
自己学出这个线性变换才能利用相对距离;注意力分数本身并不显式包含
相对位置,学习效率和归纳偏置都弱于 RoPE。
- 长度外推能力名不副实:虽然对任意 pos 编码都有定义,看似可以外推,
但 ALiBi 论文(Press et al., 2022)的实验表明:超出训练长度后,
未见过的 sin/cos 值组合会让注意力分布失真,困惑度迅速恶化——
“能算出编码"不等于"模型认识这个编码”。
- 位置与内容纠缠在同一表示中:加法注入让位置向量与语义向量占用同一组
维度、互相干扰;为了容纳位置信号,嵌入必须让出一部分容量。
- 注意力分数中的位置贡献不可控:(xe+pq)⊤(xe+pk) 展开后
同时含有"内容×内容"“内容×位置”"位置×位置"四类项,位置项与内容项耦合,
模型难以学到纯粹的相对位置规律。
5.3 旋转位置编码(RoPE)的优势
- 相对位置性质是数学恒等式:⟨RoPE(q,m),RoPE(k,n)⟩=q⊤R(n−m)k
严格只依赖 m−n(本文 2.1 节推导、fig_rope_relative 数值验证),
不需要模型额外学习,归纳偏置直接内建于注意力分数。
- 每层都注入新鲜的位置信号:q/k 在每一层注意力前都重新旋转,
位置信息不会像加法式那样随深度稀释。
- 远程衰减的归纳偏置:RoPE 论文证明了在 θi=10000−2i/d 下,
内积随相对距离整体衰减(本文 fig_rope_relative 中的振荡衰减形态),
天然符合"近邻 token 更相关"的语言先验。
- 位置与内容解耦:旋转是保模长的正交变换,只改变 q/k 的方向,
位置作用在注意力分数层面而非表示层面;value 完全不受位置污染,
语义表示的容量不被位置占用。
- 与线性注意力兼容:旋转是乘性变换,满足结合律,
在核化(线性)注意力中仍可分解出相对位置项;加法式编码则做不到。
- 易于扩展到多维位置:分轴旋转即得 2D/3D RoPE(本文第 4 节),
天然适配图像、视频、3D 体素;正余弦编码扩展到多维需要手工拼接各轴编码,
且得不到严格的相对位置性质。
- 长度外推有成熟的补救工具链:位置插值(Position Interpolation)、
NTK-aware 缩放、YaRN 等方法只需调整频率或位置缩放系数即可外推数倍上下文,
无需改架构、无需重训(或仅需少量微调)。
- 工程生态成熟:预计算 cos/sin 后只是逐元素乘加,开销极小;
FlashAttention 等高效内核已原生支持,LLaMA/Qwen 等开源权重可直接复用。
5.4 旋转位置编码(RoPE)的劣势
- 直接外推依然会失效:训练长度之外,高频分组会转到模型从未见过的角度,
注意力分数分布失真。RoPE 的外推优势体现在"有成熟的修正手段"
(PI / NTK / YaRN / 调大 base),而不是"裸跑就能外推"。
- 实现细节多、易踩坑:half 与 interleaved 两种配对约定(本文 2.1 节)
只差一个维度排列,错误混用不会报错但结果全错;迁移开源权重时必须核对约定,
cos/sin 缓存的 dtype、设备一致性也需要小心处理。
- 频率基数 base 成为新的超参数:长上下文模型需要把 base 从 104
一路调到 105∼106(如 LLaMA-2/3),具体取值依赖经验与消融实验。
- 无法直接表达绝对位置:内积抹掉了绝对位置信息。对"位置本身就是语义"
的任务(如坐标回归、依赖绝对网格位置的生成),RoPE 不如加法式编码直接,
通常需要额外补一路绝对位置嵌入。
- 位置信息只存在于注意力路径:FFN、归一化等路径感知不到位置。
这一般是无害甚至有益的解耦,但某些架构设计(如无注意力的层间混合)
需要另行考虑。
- 超长上下文下缓存与精度问题:cos/sin 缓存随 max_seq_len 线性增长
(占用很小,百万长度级才显著);极低频分组在超长序列上角度变化过慢,
位置区分度下降,这也是 NTK/YaRN 类方法要解决的问题。
5.5 实践建议:如何选择
| 场景 |
推荐 |
理由 |
| 现代 LLM(预训练 / 微调) |
RoPE |
严格相对位置 + 逐层注入 + 外推工具链,事实标准 |
| 文生视频 / 多帧生成 |
3D RoPE |
分轴编码 (t, h, w),CogVideoX / HunyuanVideo 同款 |
| 复现原始 Transformer、教学 |
正余弦 PE |
最简单、无需改动注意力,便于聚焦原理 |
| 需要显式绝对位置(坐标回归、ViT 式 2D 网格) |
加法式(可学习或正余弦) |
RoPE 的相对化反而抹掉了任务需要的绝对信息 |
| 极致长度外推(训练 4K 推理 1M) |
RoPE + YaRN/NTK,或考虑 ALiBi |
二者均有成熟方案,正余弦 PE 直接出局 |
一句话总结:正余弦 PE 赢在简单与可解释,输在位置信号弱、间接、不可外推;
RoPE 赢在把相对位置变成注意力的内建性质且生态成熟,
代价是实现约定繁琐、外推仍需借助修正技巧——这也是它成为现代大模型标配的原因。
6. 对比总结
|
正余弦 PE |
RoPE(1D) |
3D RoPE |
| 提出 |
Transformer (2017) |
RoFormer (2021) |
CogVideoX 等视频模型 |
| 位置信息 |
绝对位置(可推出相对) |
相对位置 |
三维相对位置 |
| 注入方式 |
加到嵌入上:x+PE |
旋转 q/k:xcos+rot(x)sin |
同左,按轴分段旋转 |
| 作用对象 |
输入嵌入 |
注意力的 q、k |
视频 token 的 q、k |
| 位置形式 |
标量 pos |
标量 m |
三元组 (t, h, w) |
| 可学习参数 |
无 |
无 |
无 |
| 相对位置性质 |
内积近似反映距离 |
内积严格只依赖 m−n |
内积严格只依赖 Δ=(Δt,Δh,Δw) |
| 典型用户 |
原始 Transformer |
LLaMA、Qwen、GPT-NeoX |
CogVideoX、HunyuanVideo |
一条演进主线:三者共享同一组频率 θi=10000−2i/d 与"二维分组"结构——
正余弦 PE 把各频率的 sin/cos 摆成向量相加,RoPE 发现同样的结构用来旋转 q/k
可以让相对位置性质从"近似、间接"变为"严格、直接",3D RoPE 再把这个旋转
按坐标轴复制三份,便从文本走到了视频。
参考
- Vaswani et al. Attention Is All You Need. NeurIPS 2017.
- Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. 2021.
- Yang et al. CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer. 2024.