扩散模型学习笔记:从 DDPM 到 FLUX(MNIST 实战)
本文档整合扩散模型发展的三个过程,分别实现MNIST数据集的生成,构成一条完整的扩散模型学习路径:
第一部分:基础扩散模型 —— DDPM 原理、MNIST 像素空间生成、DDIM 加速采样第二部分:Mini Stable Diffusion —— 潜空间扩散、条件注入、Classifier-Free Guidance第三部分:Mini FLUX —— Flow Matching、Euler ODE 采样、双流 MMDiT
三部分共用同一套 MNIST 实验平台,每一部分只在前一部分的基础上做增量改动,torch、torchvision。
目录
第一部分:DDPM 与 DDIM
1. Diffusion 模型的核心思想
扩散模型是一类生成模型,灵感来自非平衡热力学。它的核心思想可以用一句话概括:
学习"如何加噪"的逆过程——“如何一步步去噪”,从而把纯噪声还原成真实数据。
整个框架由两个过程组成:
前向过程(Forward / Diffusion Process) :固定的马尔可夫链,逐步向数据中加入高斯噪声,直到数据变成纯噪声。这个过程不需要学习。反向过程(Reverse Process) :学习的马尔可夫链,从纯噪声出发,逐步去噪,最终生成新的数据样本。训练的目标就是学会这个去噪过程。
1
2
前向加噪: x_0 → x_1 → x_2 → ... → x_T (≈ 纯高斯噪声) ... → x_1 → x_0 (≈ 生成的样本)
2. 前向过程
2.1 单步加噪
给定真实样本 x 0 ∼ q ( x 0 ) x_0 \sim q(x_0) x 0 ∼ q ( x 0 )
q ( x t ∣ x t − 1 ) = N ( x t ; 1 − β t x t − 1 , β t I ) q(x_t \mid x_{t-1}) = \mathcal{N}\left(x_t;\ \sqrt{1-\beta_t}\,x_{t-1},\ \beta_t \mathbf{I}\right)
q ( x t ∣ x t − 1 ) = N ( x t ; 1 − β t x t − 1 , β t I )
其中 β t ∈ ( 0 , 1 ) \beta_t \in (0,1) β t ∈ ( 0 , 1 ) β 1 < β 2 < ⋯ < β T \beta_1 < \beta_2 < \dots < \beta_T β 1 < β 2 < ⋯ < β T
等价地用重参数化写法:
x t = 1 − β t x t − 1 + β t ϵ t − 1 , ϵ t − 1 ∼ N ( 0 , I ) x_t = \sqrt{1-\beta_t}\,x_{t-1} + \sqrt{\beta_t}\,\epsilon_{t-1},\qquad \epsilon_{t-1}\sim\mathcal{N}(0,\mathbf{I})
x t = 1 − β t x t − 1 + β t ϵ t − 1 , ϵ t − 1 ∼ N ( 0 , I )
2.2 任意时间步的闭式表达
这是 DDPM 最重要的性质之一:不需要逐步迭代,可以一步到位从 x 0 x_0 x 0 t t t x t x_t x t
定义 α t = 1 − β t \alpha_t = 1-\beta_t α t = 1 − β t α ˉ t = ∏ s = 1 t α s \bar{\alpha}_t = \prod_{s=1}^{t}\alpha_s α ˉ t = ∏ s = 1 t α s
q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I ) q(x_t \mid x_0) = \mathcal{N}\left(x_t;\ \sqrt{\bar{\alpha}_t}\,x_0,\ (1-\bar{\alpha}_t)\mathbf{I}\right)
q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I )
即:
x t = α ˉ t x 0 + 1 − α ˉ t ϵ , ϵ ∼ N ( 0 , I ) \boxed{x_t = \sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon,\qquad \epsilon\sim\mathcal{N}(0,\mathbf{I})}
x t = α ˉ t x 0 + 1 − α ˉ t ϵ , ϵ ∼ N ( 0 , I )
当 T T T α ˉ T → 0 \bar{\alpha}_T \to 0 α ˉ T → 0 x T x_T x T
这个公式同时给出了训练数据的构造方式 :随机取一个 t t t x t x_t x t
2.3 噪声调度(Noise Schedule)
β t \beta_t β t
β t = β min + t T ( β max − β min ) \beta_t = \beta_{\min} + \frac{t}{T}\left(\beta_{\max}-\beta_{\min}\right)
β t = β m i n + T t ( β m a x − β m i n )
常用取值:T = 1000 T=1000 T = 1000 β min = 10 − 4 \beta_{\min}=10^{-4} β m i n = 1 0 − 4 β max = 0.02 \beta_{\max}=0.02 β m a x = 0.02
3. 反向过程
3.1 理想情况
如果能直接知道 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x T ∼ N ( 0 , I ) x_T\sim\mathcal{N}(0,\mathbf{I}) x T ∼ N ( 0 , I ) x 0 x_0 x 0 x 0 x_0 x 0
q ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) q(x_{t-1}\mid x_t, x_0) = \mathcal{N}\left(x_{t-1};\ \tilde{\mu}_t(x_t,x_0),\ \tilde{\beta}_t\mathbf{I}\right)
q ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I )
其中
β ~ t = 1 − α ˉ t − 1 1 − α ˉ t β t \tilde{\beta}_t = \frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}\,\beta_t
β ~ t = 1 − α ˉ t 1 − α ˉ t − 1 β t
μ ~ t ( x t , x 0 ) = α ˉ t − 1 β t 1 − α ˉ t x 0 + α t ( 1 − α ˉ t − 1 ) 1 − α ˉ t x t \tilde{\mu}_t(x_t,x_0) = \frac{\sqrt{\bar{\alpha}_{t-1}}\,\beta_t}{1-\bar{\alpha}_t}\,x_0 + \frac{\sqrt{\alpha_t}\,(1-\bar{\alpha}_{t-1})}{1-\bar{\alpha}_t}\,x_t
μ ~ t ( x t , x 0 ) = 1 − α ˉ t α ˉ t − 1 β t x 0 + 1 − α ˉ t α t ( 1 − α ˉ t − 1 ) x t
问题在于:采样时我们没有 x 0 x_0 x 0 p θ p_\theta p θ
3.2 用神经网络近似
DDPM 将反向过程建模为:
p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , σ t 2 I ) p_\theta(x_{t-1}\mid x_t) = \mathcal{N}\left(x_{t-1};\ \mu_\theta(x_t,t),\ \sigma_t^2\mathbf{I}\right)
p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , σ t 2 I )
方差 σ t 2 \sigma_t^2 σ t 2 β ~ t \tilde{\beta}_t β ~ t μ θ \mu_\theta μ θ
3.3 从"预测均值"到"预测噪声"
直接预测均值可行但不稳定。DDPM 论文的关键技巧是把均值的参数化方式改一下。由前向公式反解:
x 0 = x t − 1 − α ˉ t ϵ α ˉ t x_0 = \frac{x_t - \sqrt{1-\bar{\alpha}_t}\,\epsilon}{\sqrt{\bar{\alpha}_t}}
x 0 = α ˉ t x t − 1 − α ˉ t ϵ
代入 μ ~ t \tilde{\mu}_t μ ~ t
μ ~ t = 1 α t ( x t − β t 1 − α ˉ t ϵ ) \tilde{\mu}_t = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\,\epsilon\right)
μ ~ t = α t 1 ( x t − 1 − α ˉ t β t ϵ )
也就是说,均值完全由噪声 ϵ \epsilon ϵ ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵ θ ( x t , t ) 预测加入的噪声 ,均值即为:
μ θ ( x t , t ) = 1 α t ( x t − β t 1 − α ˉ t ϵ θ ( x t , t ) ) \mu_\theta(x_t,t) = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\,\epsilon_\theta(x_t,t)\right)
μ θ ( x t , t ) = α t 1 ( x t − 1 − α ˉ t β t ϵ θ ( x t , t ) )
3.4 训练目标
生成模型的标准目标是最大化似然 p θ ( x 0 ) p_\theta(x_0) p θ ( x 0 )
L simple = E x 0 , t , ϵ ∥ ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) ∥ 2 \boxed{\mathcal{L}_{\text{simple}} = \mathbb{E}_{x_0,\,t,\,\epsilon}\left\|\epsilon - \epsilon_\theta\left(\sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon,\ t\right)\right\|^2}
L simple = E x 0 , t , ϵ ϵ − ϵ θ ( α ˉ t x 0 + 1 − α ˉ t ϵ , t ) 2
训练算法 (每次迭代):
从数据集中采样 x 0 x_0 x 0
随机采样时间步 t ∼ Uniform { 1 , … , T } t \sim \text{Uniform}\{1,\dots,T\} t ∼ Uniform { 1 , … , T }
采样噪声 ϵ ∼ N ( 0 , I ) \epsilon \sim \mathcal{N}(0,\mathbf{I}) ϵ ∼ N ( 0 , I )
计算 x t = α ˉ t x 0 + 1 − α ˉ t ϵ x_t = \sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon x t = α ˉ t x 0 + 1 − α ˉ t ϵ
以 ∥ ϵ − ϵ θ ( x t , t ) ∥ 2 \|\epsilon - \epsilon_\theta(x_t, t)\|^2 ∥ ϵ − ϵ θ ( x t , t ) ∥ 2
采样算法 (生成新图像):
采样 x T ∼ N ( 0 , I ) x_T \sim \mathcal{N}(0,\mathbf{I}) x T ∼ N ( 0 , I )
对 t = T , T − 1 , … , 1 t = T, T-1, \dots, 1 t = T , T − 1 , … , 1 x t − 1 = 1 α t ( x t − β t 1 − α ˉ t ϵ θ ( x t , t ) ) + σ t z , z ∼ N ( 0 , I ) x_{t-1} = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\,\epsilon_\theta(x_t,t)\right) + \sigma_t\,z,\qquad z\sim\mathcal{N}(0,\mathbf{I})
x t − 1 = α t 1 ( x t − 1 − α ˉ t β t ϵ θ ( x t , t ) ) + σ t z , z ∼ N ( 0 , I )
(t = 1 t=1 t = 1
返回 x 0 x_0 x 0
4. 网络结构:带时间条件的 U-Net
ϵ θ ( x t , t ) \epsilon_\theta(x_t, t) ϵ θ ( x t , t ) t t t U-Net :
下采样路径 :卷积逐步提取特征、降低分辨率上采样路径 :转置卷积/插值逐步恢复分辨率跳跃连接(skip connection) :把下采样各层的特征拼到对应的上采样层,保留细节信息时间嵌入 :将 t t t
正弦时间嵌入的公式(d d d
emb ( t ) 2 i = sin ( t 10000 2 i / d ) , emb ( t ) 2 i + 1 = cos ( t 10000 2 i / d ) \text{emb}(t)_{2i} = \sin\left(\frac{t}{10000^{2i/d}}\right),\qquad \text{emb}(t)_{2i+1} = \cos\left(\frac{t}{10000^{2i/d}}\right)
emb ( t ) 2 i = sin ( 1000 0 2 i / d t ) , emb ( t ) 2 i + 1 = cos ( 1000 0 2 i / d t )
5. DDPM 的 MNIST 完整实现
下面是一个完整的、可直接运行的实现,包含训练与采样。环境要求:torch、torchvision。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 import osimport mathimport torchimport torch.nn as nnimport torch.nn.functional as Ffrom torch.utils.data import DataLoaderfrom torchvision import datasets, transformsfrom torchvision.utils import save_image1000 1e-4 0.02 128 10 2e-4 128 32 "cuda" if torch.cuda.is_available() else "cpu" "output/basic_ddpm" True )def make_schedule (T, beta_min, beta_max, device ):"""预计算 DDPM 所需的所有系数""" 1.0 - betas 0 ) 1 ], (1 , 0 ), value=1.0 )return {"betas" : betas,"alphas" : alphas,"alphas_cumprod" : alphas_cumprod,"sqrt_alphas_cumprod" : torch.sqrt(alphas_cumprod), "sqrt_one_minus_alphas_cumprod" : torch.sqrt(1.0 - alphas_cumprod),"sqrt_recip_alphas" : torch.sqrt(1.0 / alphas), "posterior_variance" : betas * (1.0 - alphas_cumprod_prev) / (1.0 - alphas_cumprod), def extract (a, t, shape ):"""从系数张量 a 中取出 t 时刻的值,并 reshape 成可与图像广播的形状""" 0 , t)return out.reshape(t.shape[0 ], *((1 ,) * (len (shape) - 1 )))def q_sample (x0, t, noise=None ):"""一步加噪: x_t = √ᾱ_t * x0 + √(1-ᾱ_t) * ε""" if noise is None :return (extract(COEF["sqrt_alphas_cumprod" ], t, x0.shape) * x0"sqrt_one_minus_alphas_cumprod" ], t, x0.shape) * noise)class SinusoidalTimeEmbedding (nn.Module):"""正弦时间嵌入,与 Transformer 的位置编码相同""" def __init__ (self, dim ):super ().__init__()self .dim = dimdef forward (self, t ):self .dim // 2 10000 ) * torch.arange(half, device=t.device) / half)float ()[:, None ] * freqs[None , :]return torch.cat([torch.sin(args), torch.cos(args)], dim=-1 ) class ResBlock (nn.Module):"""残差块: (GroupNorm + SiLU + Conv) x 2,中间注入时间嵌入,带 skip 连接""" def __init__ (self, in_ch, out_ch, time_dim ):super ().__init__()self .norm1 = nn.GroupNorm(8 , in_ch)self .conv1 = nn.Conv2d(in_ch, out_ch, 3 , padding=1 )self .norm2 = nn.GroupNorm(8 , out_ch)self .conv2 = nn.Conv2d(out_ch, out_ch, 3 , padding=1 )self .time_proj = nn.Linear(time_dim, out_ch)self .skip = nn.Conv2d(in_ch, out_ch, 1 ) if in_ch != out_ch else nn.Identity()def forward (self, x, t_emb ):self .conv1(F.silu(self .norm1(x)))self .time_proj(F.silu(t_emb))[:, :, None , None ]self .conv2(F.silu(self .norm2(h)))return h + self .skip(x)class UNet (nn.Module):""" 简化版 U-Net(针对 28x28 单通道图像): 28x28 -> 14x14 -> 7x7 -> 14x14 -> 28x28 每层通过跳跃连接拼接编码器特征。 """ def __init__ (self, base_ch=32 , time_dim=128 ):super ().__init__()self .time_mlp = nn.Sequential(4 ),4 , time_dim),2 , base_ch * 4 self .in_conv = nn.Conv2d(1 , c1, 3 , padding=1 )self .enc2 = ResBlock(c1, c2, time_dim)self .enc3 = ResBlock(c2, c3, time_dim)self .mid1 = ResBlock(c3, c3, time_dim)self .mid2 = ResBlock(c3, c3, time_dim)self .dec2 = ResBlock(c3 + c2, c2, time_dim) self .dec1 = ResBlock(c2 + c1, c1, time_dim) self .out_norm = nn.GroupNorm(8 , c1)self .out = nn.Conv2d(c1, 1 , 3 , padding=1 )def forward (self, x, t ):self .time_mlp(t)self .in_conv(x) self .enc2(F.avg_pool2d(e1, 2 ), t_emb) self .enc3(F.avg_pool2d(e2, 2 ), t_emb) self .mid2(self .mid1(e3, t_emb), t_emb) 2 , mode="nearest" ) self .dec2(torch.cat([d2, e2], dim=1 ), t_emb) 2 , mode="nearest" ) self .dec1(torch.cat([d1, e1], dim=1 ), t_emb) return self .out(F.silu(self .out_norm(d1))) def train ():0.5 ,), (0.5 ,)), "./data" , train=True , download=True , transform=transform)True ,2 , drop_last=True )for epoch in range (EPOCHS):0.0 for x0, _ in loader:0 , T, (x0.shape[0 ],), device=DEVICE)print (f"Epoch {epoch+1 :03d} /{EPOCHS} loss={total_loss/len (loader):.4 f} " )f"{SAVE_DIR} /ddpm_mnist.pt" )16 , fname=f"{SAVE_DIR} /epoch_{epoch+1 :03d} .png" )@torch.no_grad() def sample (model, n=16 , fname=None ):"""DDPM 反向采样: 从纯噪声逐步去噪""" eval ()1 , 28 , 28 , device=DEVICE)for i in reversed (range (T)):"sqrt_recip_alphas" ], t, x.shape)"betas" ], t, x.shape) / extract("sqrt_one_minus_alphas_cumprod" ], t, x.shape)if i > 0 :"posterior_variance" ], t, x.shape)else :1 , 1 ) + 1 ) / 2 if fname:int (n ** 0.5 ))return xif __name__ == "__main__" :
运行方式:
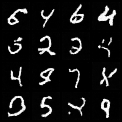
训练过程中会在 output/basic_ddpm/ 目录下保存模型权重 ddpm_mnist.pt 和每个 epoch 的采样结果 epoch_XXX.png。在单张 GPU 上约 10 个 epoch 即可看到清晰的手写数字。
训练完成后的生成结果(16 张随机样本):
6. DDIM:加速采样
6.1 动机
DDPM 的反向过程是一条马尔可夫链,必须严格走完 t = T , T − 1 , … , 1 t=T, T-1, \dots, 1 t = T , T − 1 , … , 1 T T T T = 1000 T=1000 T = 1000
DDIM(Denoising Diffusion Implicit Models)的核心观察是:DDPM 的训练目标只依赖边缘分布 q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) 。也就是说,可以构造一族不同的前向过程,它们拥有完全相同的 q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) 训练好的 DDPM 模型无需重新训练即可直接使用 ,但其中一些前向过程对应的反向采样可以跳步、甚至完全确定性地进行。
6.2 非马尔可夫前向过程
DDIM 定义前向过程为(σ t \sigma_t σ t
q σ ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; α ˉ t − 1 x 0 + 1 − α ˉ t − 1 − σ t 2 ⋅ x t − α ˉ t x 0 1 − α ˉ t , σ t 2 I ) q_\sigma(x_{t-1}\mid x_t, x_0) = \mathcal{N}\left(x_{t-1};\ \sqrt{\bar{\alpha}_{t-1}}\,x_0 + \sqrt{1-\bar{\alpha}_{t-1}-\sigma_t^2}\cdot\frac{x_t-\sqrt{\bar{\alpha}_t}\,x_0}{\sqrt{1-\bar{\alpha}_t}},\ \sigma_t^2\mathbf{I}\right)
q σ ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; α ˉ t − 1 x 0 + 1 − α ˉ t − 1 − σ t 2 ⋅ 1 − α ˉ t x t − α ˉ t x 0 , σ t 2 I )
注意它直接以 x 0 x_0 x 0 q ( x t ∣ x 0 ) = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I ) q(x_t\mid x_0)=\mathcal{N}(\sqrt{\bar{\alpha}_t}x_0,(1-\bar{\alpha}_t)\mathbf{I}) q ( x t ∣ x 0 ) = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I )
两个重要的特例:
当 σ t = 1 − α ˉ t − 1 1 − α ˉ t 1 − α ˉ t α ˉ t − 1 \sigma_t = \sqrt{\frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}}\sqrt{1-\frac{\bar{\alpha}_t}{\bar{\alpha}_{t-1}}} σ t = 1 − α ˉ t 1 − α ˉ t − 1 1 − α ˉ t − 1 α ˉ t
当 σ t = 0 \sigma_t = 0 σ t = 0 确定性 的——这就是"implicit model"名字的由来。
实际使用中通常引入系数 η ∈ [ 0 , 1 ] \eta\in[0,1] η ∈ [ 0 , 1 ]
σ t ( η ) = η 1 − α ˉ t − 1 1 − α ˉ t 1 − α ˉ t α ˉ t − 1 \sigma_t(\eta) = \eta\sqrt{\frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}}\sqrt{1-\frac{\bar{\alpha}_t}{\bar{\alpha}_{t-1}}}
σ t ( η ) = η 1 − α ˉ t 1 − α ˉ t − 1 1 − α ˉ t − 1 α ˉ t
η = 0 \eta=0 η = 0 η = 1 \eta=1 η = 1
6.3 DDIM 采样公式
将网络预测的噪声 ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵ θ ( x t , t )
x ^ 0 = x t − 1 − α ˉ t ϵ θ ( x t , t ) α ˉ t \hat{x}_0 = \frac{x_t - \sqrt{1-\bar{\alpha}_t}\,\epsilon_\theta(x_t,t)}{\sqrt{\bar{\alpha}_t}}
x ^ 0 = α ˉ t x t − 1 − α ˉ t ϵ θ ( x t , t )
然后一步得到 x t − 1 x_{t-1} x t − 1
x t − 1 = α ˉ t − 1 x ^ 0 + 1 − α ˉ t − 1 − σ t 2 ϵ θ ( x t , t ) + σ t z , z ∼ N ( 0 , I ) \boxed{x_{t-1} = \sqrt{\bar{\alpha}_{t-1}}\,\hat{x}_0 + \sqrt{1-\bar{\alpha}_{t-1}-\sigma_t^2}\,\epsilon_\theta(x_t,t) + \sigma_t z,\qquad z\sim\mathcal{N}(0,\mathbf{I})}
x t − 1 = α ˉ t − 1 x ^ 0 + 1 − α ˉ t − 1 − σ t 2 ϵ θ ( x t , t ) + σ t z , z ∼ N ( 0 , I )
直观理解:x ^ 0 \hat{x}_0 x ^ 0 x t x_t x t
6.4 跳步采样
因为训练目标对任意 t t t T T T S ≪ T S \ll T S ≪ T
{ τ 1 < τ 2 < ⋯ < τ S } ⊂ { 1 , … , T } \{\tau_1 < \tau_2 < \dots < \tau_S\} \subset \{1,\dots,T\}
{ τ 1 < τ 2 < ⋯ < τ S } ⊂ { 1 , … , T }
只在子序列上执行上述更新公式(公式中的 α ˉ t − 1 \bar{\alpha}_{t-1} α ˉ t − 1 α ˉ τ i − 1 \bar{\alpha}_{\tau_{i-1}} α ˉ τ i − 1 S S S S = 50 S=50 S = 50
DDIM 还带来两个额外好处:
确定性生成 (η = 0 \eta=0 η = 0 x T x_T x T 潜空间插值 :两个初始噪声之间做球面插值,生成结果会平滑过渡,说明 x T x_T x T
6.5 实现
basic_ddim.py 是一个可独立运行的完整文件:模型结构(ResBlock/UNet)、噪声调度(make_schedule/q_sample)和训练循环与第 5 节的 basic_ddpm.py 完全相同 (DDIM 复用 DDPM 的训练目标,无需改动训练代码),相同部分不再重复列出。区别只有三处:噪声调度输出目录为 output/basic_ddim、权重保存为 ddim_mnist.pt、每个 epoch 用下面的 ddim_sample 代替 DDPM 的 sample——该函数与 DDPM 共用同一套调度系数 COEF,无需重新训练即可直接加载 DDPM 训练好的权重:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
@torch.no_grad() def ddim_sample (model, n=16 , steps=50 , eta=0.0 , fname=None ):""" DDIM 采样: 跳步 + 可选确定性 steps: 实际采样步数 S(远小于 T) eta: 0.0 为确定性采样, 1.0 等价于 DDPM 的随机采样 """ eval ()0 , T - 1 , steps, device=DEVICE).long()1 , 28 , 28 , device=DEVICE)for i in reversed (range (len (times))):"alphas_cumprod" ][t]"alphas_cumprod" ][times[i - 1 ]] if i > 0 else torch.tensor(1.0 , device=DEVICE)1.0 - alpha_t) * eps) / torch.sqrt(alpha_t)1.0 - alpha_prev) / (1.0 - alpha_t)) \1.0 - alpha_t / alpha_prev)1.0 - alpha_prev - sigma ** 2 ).clamp(min =0 )) * epsif i > 0 and sigma > 0 :1 , 1 ) + 1 ) / 2 if fname:int (n ** 0.5 ))return x
train() 中保存权重与采样的两行相应改为(其余训练代码与 basic_ddpm.py 一致):
1
2
torch.save(model.state_dict(), f"{SAVE_DIR} /ddim_mnist.pt" )16 , steps=50 , eta=0.0 , fname=f"{SAVE_DIR} /epoch_{epoch+1 :03d} .png" )
运行方式:
输出保存在 output/basic_ddim/。与 DDPM 对比可以直观观察速度差异:
对比实验建议:
配置
推理次数
特点
DDPM(第 5 节 sample)
1000
原始质量,最慢
ddim_sample(steps=50, eta=0)50
确定性,质量接近 DDPM
ddim_sample(steps=20, eta=0)20
更快,开始出现细节损失
ddim_sample(steps=50, eta=1)50
随机采样,多样性略增
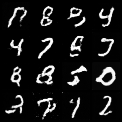
确定性(η = 0 \eta=0 η = 0 ddim_sample,生成的图像完全一致;而 DDPM 采样每次结果都不同。
DDIM 50 步确定性采样(η = 0 \eta=0 η = 0
7. 代码与公式的对应关系(DDPM/DDIM)
公式
代码位置
β t \beta_t β t make_schedule 中的 torch.linspace
x t = α ˉ t x 0 + 1 − α ˉ t ϵ x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon x t = α ˉ t x 0 + 1 − α ˉ t ϵ q_sample()
正弦时间嵌入
SinusoidalTimeEmbedding
噪声预测网络 ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵ θ ( x t , t )
UNet
L = ∣ ϵ − ϵ θ ( x t , t ) ∣ 2 \mathcal{L} = |\epsilon - \epsilon_\theta(x_t,t)|^2 L = ∣ ϵ − ϵ θ ( x t , t ) ∣ 2 train() 中的 F.mse_loss(pred, noise)
μ θ = 1 α t ( x t − β t 1 − α ˉ t ϵ θ ) \mu_\theta = \frac{1}{\sqrt{\alpha_t}}\big(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta\big) μ θ = α t 1 ( x t − 1 − α ˉ t β t ϵ θ ) sample() 中的 mean
x t − 1 = μ θ + β ~ t z x_{t-1} = \mu_\theta + \sqrt{\tilde\beta_t}\,z x t − 1 = μ θ + β ~ t z sample() 循环体
x ^ 0 = ( x t − 1 − α ˉ t ϵ θ ) / α ˉ t \hat{x}_0 = \big(x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta\big)/\sqrt{\bar\alpha_t} x ^ 0 = ( x t − 1 − α ˉ t ϵ θ ) / α ˉ t ddim_sample() 中的 x0_pred
DDIM 更新 x t − 1 = α ˉ t − 1 x ^ 0 + 1 − α ˉ t − 1 − σ 2 ϵ θ + σ z x_{t-1}=\sqrt{\bar\alpha_{t-1}}\hat{x}_0+\sqrt{1-\bar\alpha_{t-1}-\sigma^2}\epsilon_\theta+\sigma z x t − 1 = α ˉ t − 1 x ^ 0 + 1 − α ˉ t − 1 − σ 2 ϵ θ + σ z
ddim_sample() 循环体
第二部分:Mini Stable Diffusion
基础 DDPM 已经能在像素空间生成图像,但距离 Stable Diffusion(SD)还差三件事:
8. 从 DDPM 到 Stable Diffusion:三个增量
增量
解决的问题
SD 中的部件
本实现中的对应
① 潜空间扩散
像素空间计算量大
KL-VAE
tiny AutoEncoder
② 条件注入
无法控制生成内容
CLIP 文本编码器 + cross-attention
类别标签 embedding(“文本” = 数字 0~9)
③ Classifier-Free Guidance
条件强度不可调
CFG
CFG
整体架构(LDM / SD 的标准结构):
1
2
3
4
5
6
7
8
9
像素空间 潜空间x ──enc──► z_0 ──► 前向加噪 z_0 → z_1 → ... → z_T │, t, c ) U-Net │ 在潜空间进行x ̂ ◄──dec── z_0 ◄── z_T → ... → z_1 → z_0 │c (文本/标签)经编码后注入 U-Net 每一层
训练好之后的生成流程:先在潜空间中从纯噪声去噪得到 z 0 z_0 z 0 。
9. 增量①:潜空间扩散(Latent Diffusion)
9.1 为什么不在像素空间做扩散
一张 512 × 512 × 3 512\times512\times3 512 × 512 × 3
LDM(Latent Diffusion Model,SD 的正式名称)的思路:先用一个自编码器把图像压缩到一个语义等效但维度小得多的潜空间,扩散过程全部在潜空间进行 。SD 的 VAE 把 512 × 512 × 3 512\times512\times3 512 × 512 × 3 64 × 64 × 4 64\times64\times4 64 × 64 × 4
9.2 自编码器与潜变量缩放
SD 使用的是 KL-VAE(编码器输出高斯分布参数,用 KL 散度正则化潜空间)。在 mini 版本中用普通自编码器(MSE 重建损失)即可达到同样目的:
L A E = ∥ x − dec ( enc ( x ) ) ∥ 2 \mathcal{L}_{AE} = \|x - \text{dec}(\text{enc}(x))\|^2
L A E = ∥ x − dec ( enc ( x )) ∥ 2
AE 先单独训练若干轮,然后冻结 ,作为像素空间与潜空间之间固定的桥梁。
一个重要的工程细节:AE 编码出的潜变量 z z z α ˉ t \bar{\alpha}_t α ˉ t
z norm = z σ z , σ z = 训练集上潜变量的标准差 z_{\text{norm}} = \frac{z}{\sigma_z},\qquad \sigma_z = \text{训练集上潜变量的标准差}
z norm = σ z z , σ z = 训练集上潜变量的标准差
解码时再乘回 σ z \sigma_z σ z 0.18215 起的就是这个作用(它是 SD 的 VAE 在训练数据上潜变量标准差的倒数)。
9.3 训练与采样的变化
与像素空间 DDPM 相比,公式完全不变,只是把所有 x x x z z z
训练:z 0 = enc ( x ) / σ z z_0 = \text{enc}(x)/\sigma_z z 0 = enc ( x ) / σ z z t = α ˉ t z 0 + 1 − α ˉ t ϵ z_t = \sqrt{\bar{\alpha}_t}z_0 + \sqrt{1-\bar{\alpha}_t}\epsilon z t = α ˉ t z 0 + 1 − α ˉ t ϵ
采样:DDIM 在潜空间走完得到 z 0 z_0 z 0 x ^ = dec ( z 0 ⋅ σ z ) \hat{x} = \text{dec}(z_0 \cdot \sigma_z) x ^ = dec ( z 0 ⋅ σ z )
10. 增量②:条件注入
10.1 真实 SD 的做法
SD 的条件是自由文本。CLIP 文本编码器把 prompt 编码为 77 个 token 的特征序列,U-Net 的每个 ResBlock 后面接一个 cross-attention 层:图像特征作为 query,文本 token 特征作为 key/value,让每个图像区域"读取"相关的文本信息。
10.2 mini 版的简化
本实现用数字类别 0~9 作为"文本"。此时条件序列只有 1 个 token——而 cross-attention 对单个 key 的 softmax 恒为 1,attention 退化成一次线性变换再加法。所以 mini 版可以直接采用与时间步 t t t
h ← h + W t ϕ ( t ) + W c ψ ( c ) h \leftarrow h + W_t\,\phi(t) + W_c\,\psi(c)
h ← h + W t ϕ ( t ) + W c ψ ( c )
其中 ψ ( c ) \psi(c) ψ ( c ) W c W_c W c
11. 增量③:Classifier-Free Guidance(CFG)
11.1 动机与原理
朴素条件生成中,条件 c c c
由贝叶斯公式 p ( c ∣ x ) ∝ p ( x ∣ c ) / p ( x ) p(c\mid x) \propto p(x\mid c)/p(x) p ( c ∣ x ) ∝ p ( x ∣ c ) / p ( x )
∇ x log p ( x ∣ c ) = ∇ x log p ( x ) + ∇ x log p ( c ∣ x ) \nabla_x \log p(x\mid c) = \nabla_x \log p(x) + \nabla_x \log p(c\mid x)
∇ x log p ( x ∣ c ) = ∇ x log p ( x ) + ∇ x log p ( c ∣ x )
即条件 score = 无条件 score + 一个隐式分类器的梯度 。给分类器项加个权重 w w w
ϵ ~ θ ( z t , t , c ) = ϵ θ ( z t , t , ∅ ) + w [ ϵ θ ( z t , t , c ) − ϵ θ ( z t , t , ∅ ) ] \boxed{\tilde{\epsilon}_\theta(z_t, t, c) = \epsilon_\theta(z_t, t, \varnothing) + w\,\big[\epsilon_\theta(z_t, t, c) - \epsilon_\theta(z_t, t, \varnothing)\big]}
ϵ ~ θ ( z t , t , c ) = ϵ θ ( z t , t , ∅ ) + w [ ϵ θ ( z t , t , c ) − ϵ θ ( z t , t , ∅ ) ]
w = 0 w=0 w = 0 w = 1 w=1 w = 1 w > 1 w>1 w > 1
11.2 训练:条件丢弃
注意公式里需要同一个网络 同时能输出条件预测和无条件预测,这通过训练时的"条件丢弃"实现:以一定概率(通常 10%)把条件 c c c ∅ \varnothing ∅ p ( x ∣ c ) p(x\mid c) p ( x ∣ c ) p ( x ) p(x) p ( x )
11.3 采样:双前向外推
采样时每个时间步跑两次网络前向(条件、无条件各一次),按上面的公式外推,再用外推后的 ϵ ~ \tilde{\epsilon} ϵ ~
12. Mini SD 的 MNIST 完整实现
单文件实现:tiny AE(28 × 28 × 1 ↔ 14 × 14 × 4 28\times28\times1 \leftrightarrow 14\times14\times4 28 × 28 × 1 ↔ 14 × 14 × 4 torch、torchvision。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 import osimport mathimport torchimport torch.nn as nnimport torch.nn.functional as Ffrom torch.utils.data import DataLoaderfrom torchvision import datasets, transformsfrom torchvision.utils import save_image1000 1e-4 , 0.02 128 2 10 1e-3 , 2e-4 4 64 128 10 0.1 "cuda" if torch.cuda.is_available() else "cpu" "output/mini_sd" True )1.0 - betas, dim=0 ) def extract (a, t, shape ):"""取出 a[t] 并 reshape 成可广播到图像的形状""" return a.gather(0 , t).reshape(t.shape[0 ], *((1 ,) * (len (shape) - 1 )))class TinyAutoencoder (nn.Module):"""28x28x1 <-> 14x14x4,MSE 重建训练,代替 SD 的 KL-VAE""" def __init__ (self, latent_ch=4 ):super ().__init__()self .encoder = nn.Sequential(1 , 32 , 3 , stride=2 , padding=1 ), 32 , latent_ch, 3 , padding=1 ),self .decoder = nn.Sequential(32 , 3 , padding=1 ),32 , 1 , 4 , stride=2 , padding=1 ), def forward (self, x ):return self .decoder(self .encoder(x))class SinusoidalTimeEmbedding (nn.Module):def __init__ (self, dim ):super ().__init__()self .dim = dimdef forward (self, t ):self .dim // 2 10000 ) * torch.arange(half, device=t.device) / half)float ()[:, None ] * freqs[None , :]return torch.cat([torch.sin(args), torch.cos(args)], dim=-1 )class CondResBlock (nn.Module):"""ResBlock + 双路条件注入:时间 t 与条件 c 用同样方式(投影到通道后相加)""" def __init__ (self, in_ch, out_ch, emb_dim ):super ().__init__()self .norm1 = nn.GroupNorm(min (8 , in_ch), in_ch)self .conv1 = nn.Conv2d(in_ch, out_ch, 3 , padding=1 )self .norm2 = nn.GroupNorm(min (8 , out_ch), out_ch)self .conv2 = nn.Conv2d(out_ch, out_ch, 3 , padding=1 )self .t_proj = nn.Linear(emb_dim, out_ch) self .c_proj = nn.Linear(emb_dim, out_ch) self .skip = nn.Conv2d(in_ch, out_ch, 1 ) if in_ch != out_ch else nn.Identity()def forward (self, x, t_emb, c_emb ):self .conv1(F.silu(self .norm1(x)))self .t_proj(F.silu(t_emb))[:, :, None , None ]self .c_proj(F.silu(c_emb))[:, :, None , None ]self .conv2(F.silu(self .norm2(h)))return h + self .skip(x)class CondUNet (nn.Module):"""在潜空间(14x14x4)工作的条件 U-Net,预测噪声 ε_θ(z_t, t, c)""" def __init__ (self, latent_ch=4 , base_ch=64 , emb_dim=128 ):super ().__init__()self .time_mlp = nn.Sequential(self .label_emb = nn.Embedding(NUM_CLASSES + 1 , emb_dim)2 self .in_conv = nn.Conv2d(latent_ch, c1, 3 , padding=1 )self .down = CondResBlock(c1, c2, emb_dim) self .mid1 = CondResBlock(c2, c2, emb_dim)self .mid2 = CondResBlock(c2, c2, emb_dim)self .up = CondResBlock(c2 + c1, c1, emb_dim) self .out_norm = nn.GroupNorm(8 , c1)self .out_conv = nn.Conv2d(c1, latent_ch, 3 , padding=1 )def forward (self, z, t, y ):self .time_mlp(t)self .label_emb(y)self .in_conv(z) self .down(F.avg_pool2d(h0, 2 ), t_emb, c_emb) self .mid2(self .mid1(h1, t_emb, c_emb), t_emb, c_emb)2 , mode="nearest" ), h0], dim=1 )self .up(u, t_emb, c_emb) return self .out_conv(F.silu(self .out_norm(u))) def get_dataloader ():0.5 ,), (0.5 ,)), "./data" , train=True , download=True , transform=transform)return DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True ,2 , drop_last=True )def train ():for epoch in range (AE_EPOCHS):0.0 for x, _ in loader:print (f"[AE] epoch {epoch+1 } /{AE_EPOCHS} recon_loss={total/len (loader):.5 f} " )False ).eval ()with torch.no_grad():next (iter (loader))print (f"latent_std = {latent_std:.3 f} " )for epoch in range (DIFF_EPOCHS):0.0 for x, y in loader:with torch.no_grad():0 ], device=DEVICE) < CFG_DROP_PROB0 , T, (z0.shape[0 ],), device=DEVICE)1 - alphas_cumprod).sqrt(), t, z0.shape) * eps)print (f"[Diff] epoch {epoch+1 } /{DIFF_EPOCHS} loss={total/len (loader):.4 f} " )"model" : model.state_dict(), "ae" : ae.state_dict(),"latent_std" : latent_std}, f"{SAVE_DIR} /mini_sd.pt" )10 , device=DEVICE),50 , w=3.0 , fname=f"{SAVE_DIR} /epoch_{epoch+1 :03d} .png" )@torch.no_grad() def sample (model, ae, latent_std, y, steps=50 , eta=0.0 , w=3.0 , fname=None ):""" 在潜空间做 DDIM 采样,每步用 CFG 双前向外推,最后解码回像素。 y: 想生成的类别(batch 内可以各不相同) steps: DDIM 跳步数 w: CFG 引导强度,w=0 无条件,w=1 普通条件,w>1 强条件 """ eval ()0 ]1 , 0 , steps, device=DEVICE).long()14 , 14 , device=DEVICE)for i in range (len (times)):1 ]] if i + 1 < len (times) \else torch.tensor(1.0 , device=DEVICE)1 - alpha_t) * eps) / torch.sqrt(alpha_t)1 - alpha_prev) / (1 - alpha_t)) \1 - alpha_t / alpha_prev)1 - alpha_prev - sigma ** 2 ).clamp(min =0 )) * epsif i + 1 < len (times) and sigma > 0 :1 , 1 ) + 1 ) / 2 if fname:return xif __name__ == "__main__" :
运行方式:
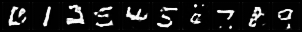
训练分两个阶段:先训 2 个 epoch 的自编码器并冻结,再在潜空间训 10 个 epoch 的扩散模型。输出保存在 output/mini_sd/,每个 epoch 生成一张 0~9 的数字条带图(nrow=10,每列一个类别),可以直观看到条件控制是否生效。
训练完成后的条件生成结果(0~9 每类各一张,w = 3.0 w=3.0 w = 3.0
13. 代码与公式的对应关系(Mini SD)
公式
代码位置
L A E = ∣ x − dec ( enc ( x ) ) ∣ 2 \mathcal{L}_{AE} = |x - \text{dec}(\text{enc}(x))|^2 L A E = ∣ x − dec ( enc ( x )) ∣ 2 train() 阶段一中的 F.mse_loss(ae(x), x)
z norm = z / σ z z_{\text{norm}} = z/\sigma_z z norm = z / σ z train() 中的 ae.encoder(x) / latent_std 与 sample() 末尾的 ae.decoder(z * latent_std)
z t = α ˉ t z 0 + 1 − α ˉ t ϵ z_t = \sqrt{\bar\alpha_t}z_0 + \sqrt{1-\bar\alpha_t}\epsilon z t = α ˉ t z 0 + 1 − α ˉ t ϵ train() 阶段二中的 zt
条件注入 h ← h + W t ϕ ( t ) + W c ψ ( c ) h \leftarrow h + W_t\phi(t) + W_c\psi(c) h ← h + W t ϕ ( t ) + W c ψ ( c )
CondResBlock.forward() 中的两次相加
CFG 条件丢弃
torch.where(drop, NULL_CLASS, y)
ϵ ~ = ϵ ∅ + w ( ϵ c − ϵ ∅ ) \tilde{\epsilon} = \epsilon_{\varnothing} + w(\epsilon_c - \epsilon_{\varnothing}) ϵ ~ = ϵ ∅ + w ( ϵ c − ϵ ∅ ) sample() 中的 eps_uncond + w * (eps_cond - eps_uncond)
DDIM 更新
sample() 循环体
x ^ = dec ( z 0 ⋅ σ z ) \hat{x} = \text{dec}(z_0\cdot\sigma_z) x ^ = dec ( z 0 ⋅ σ z ) sample() 末尾的 ae.decoder(z * latent_std)
第三部分:Mini FLUX
FLUX(以及 Stable Diffusion 3)在 SD 的基础上又做了三处核心改动:
14. 从 SD 到 FLUX:换掉三件,继承三件
FLUX(以及 SD3)与经典 SD 的关系可以概括为"三换三不换":
SD(第二部分)
FLUX(本部分)
潜空间(VAE/AE)
✅ 继承
✅ 原样保留
条件机制 + CFG
✅ 继承
✅ 公式一字不差
文本编码器
CLIP
T5(本实现仍用类别 embedding)
训练目标 预测噪声 ϵ \epsilon ϵ
❌ 换成预测速度 v v v
采样器 DDPM/DDIM(1000/50 步)
❌ 换成 Euler 解 ODE(约 20 步)
主干网络 U-Net
❌ 换成双流 MMDiT(纯 Transformer)
骨架不变,换掉的是三件内核:
1 2 3 4 5 6 7 -- -- > -- -- > -- -- > + + - - + - -
15. Flow Matching:把扩散拉成直线
15.1 直线插值路径
回顾 DDPM 的加噪公式 z t = α ˉ t z 0 + 1 − α ˉ t ϵ z_t = \sqrt{\bar\alpha_t}z_0 + \sqrt{1-\bar\alpha_t}\epsilon z t = α ˉ t z 0 + 1 − α ˉ t ϵ z 0 z_0 z 0 ϵ \epsilon ϵ t t t
Flow Matching(本文档使用其最简洁的形式,即 rectified flow / SD3 与 FLUX 采用的形式化)把路径直接定义为直线插值 ,时间也改为连续的 t ∈ [ 0 , 1 ] t\in[0,1] t ∈ [ 0 , 1 ]
z t = ( 1 − t ) z 0 + t ϵ , ϵ ∼ N ( 0 , I ) z_t = (1-t)\,z_0 + t\,\epsilon,\qquad \epsilon\sim\mathcal{N}(0,\mathbf{I})
z t = ( 1 − t ) z 0 + t ϵ , ϵ ∼ N ( 0 , I )
t = 0 t=0 t = 0 t = 1 t=1 t = 1 z t z_t z t t t t
d z t d t = ϵ − z 0 ≜ v \frac{\mathrm{d}z_t}{\mathrm{d}t} = \epsilon - z_0 \triangleq v
d t d z t = ϵ − z 0 ≜ v
即样本从数据流向噪声的速度 。
15.2 训练目标:预测速度
既然速度就是 ϵ − z 0 \epsilon - z_0 ϵ − z 0 v θ ( z t , t , c ) v_\theta(z_t, t, c) v θ ( z t , t , c )
L F M = E z 0 , t , ϵ ∥ v θ ( ( 1 − t ) z 0 + t ϵ , t , c ) − ( ϵ − z 0 ) ∥ 2 \boxed{\mathcal{L}_{FM} = \mathbb{E}_{z_0,\,t,\,\epsilon}\left\|v_\theta\big((1-t)z_0 + t\epsilon,\ t,\ c\big) - (\epsilon - z_0)\right\|^2}
L F M = E z 0 , t , ϵ v θ ( ( 1 − t ) z 0 + t ϵ , t , c ) − ( ϵ − z 0 ) 2
与 DDPM 的训练循环对比,只有三处改动:
t t t 加噪公式换成直线插值;
回归目标从 ϵ \epsilon ϵ v = ϵ − z 0 v = \epsilon - z_0 v = ϵ − z 0
15.3 采样:Euler 解 ODE
v θ v_\theta v θ
d z d t = v θ ( z , t , c ) \frac{\mathrm{d}z}{\mathrm{d}t} = v_\theta(z, t, c)
d t d z = v θ ( z , t , c )
从 t = 1 t=1 t = 1 t = 0 t=0 t = 0
z ← z − v θ ( z , t , c ) ⋅ Δ t , Δ t = 1 S z \leftarrow z - v_\theta(z, t, c)\cdot\Delta t,\qquad \Delta t = \frac{1}{S}
z ← z − v θ ( z , t , c ) ⋅ Δ t , Δ t = S 1
走 S S S 这就是为什么 FLUX 用 20 步就能生成,而 DDPM 需要 1000 步 。CFG 的用法与 SD 完全相同:每步对条件和无条件各前向一次,外推 v ~ = v ∅ + w ( v c − v ∅ ) \tilde v = v_\varnothing + w(v_c - v_\varnothing) v ~ = v ∅ + w ( v c − v ∅ )
15.4 时间步采样:logit-normal
训练时 t t t logit-normal 采样:
t = sigmoid ( u ) , u ∼ N ( 0 , 1 ) t = \text{sigmoid}(u),\qquad u\sim\mathcal{N}(0,1)
t = sigmoid ( u ) , u ∼ N ( 0 , 1 )
sigmoid 把钟形分布压到 ( 0 , 1 ) (0,1) ( 0 , 1 ) t = 0.5 t=0.5 t = 0.5
FLUX/SD3 用 MMDiT (Multimodal Diffusion Transformer)取代 U-Net。它由三部分组成:patchify、N N N
16.1 Patchify 与位置编码
Transformer 处理的是 token 序列,所以先把潜变量切成 patch。14 × 14 × 4 14\times14\times4 14 × 14 × 4 2 × 2 2\times2 2 × 2 7 × 7 = 49 7\times7=49 7 × 7 = 49 d d d
patchify: [ B , 4 , 14 , 14 ] → [ B , 49 , d ] \text{patchify: } [B,4,14,14] \rightarrow [B,49,d]
patchify: [ B , 4 , 14 , 14 ] → [ B , 49 , d ]
Transformer 本身没有位置概念,给每个 token 加上固定的 2D sin-cos 位置编码 (前一半维度编码行号,后一半编码列号)。FLUX 实际使用 RoPE(旋转位置编码),思想上同样是注入位置信息。
16.2 adaLN-Zero:条件调制
U-Net 中条件是"投影后加到特征上";DiT 系列改用更强的 adaLN-Zero (adaptive LayerNorm):
LayerNorm 不带可学习仿射参数(elementwise_affine=False);
由条件向量(时间 t t t 回归出每层的调制参数 ——每个 block 6 组:attention 前的 shift/scale/gate 和 MLP 前的 shift/scale/gate;
对 LayerNorm 输出做 modulate ( h ) = h ⋅ ( 1 + scale ) + shift \text{modulate}(h) = h\cdot(1+\text{scale}) + \text{shift} modulate ( h ) = h ⋅ ( 1 + scale ) + shift
回归网络零初始化 :起步时所有 shift/scale/gate 都是 0,gate=0 使残差分支不起作用,整个 block 初始等价于恒等映射,训练更稳定。
16.3 双流结构
MMDiT 的"MM"(多模态)体现在:图像 token 和文本 token 各有一套完整的参数 (各自的 LayerNorm、QKV 投影、输出投影、MLP),唯一的交互点是每层中间的一次联合 attention ——把两路 token 拼成一个序列做一次 softmax ( Q K ⊤ ) V \text{softmax}(QK^\top)V softmax ( Q K ⊤ ) V
1
2
3
4
img tokens ──┐ (各自的 adaLN、QKV) ┌──► img tokens tokens ──┘ (无参数) └──► txt tokens
这样文本信息通过 attention 流入图像 token,图像 token 的梯度也能反过来塑造文本表示。本实现中"文本"仍只有 1 个类别 token,但结构与 FLUX 完全同构——换成 T5 输出的多 token 文本序列即可直接扩展。
16.4 Final layer 与 unpatchify
最后再用一次 adaLN 调制,然后线性投影回每个 patch 的像素(d → p 2 ⋅ c d \rightarrow p^2\cdot c d → p 2 ⋅ c [ B , 4 , 14 , 14 ] [B,4,14,14] [ B , 4 , 14 , 14 ] v ^ \hat v v ^
17. Mini FLUX 的 MNIST 完整实现
单文件实现:tiny AE + Flow Matching 训练 + 双流 MMDiT + Euler/CFG 采样。torch、torchvision。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 260 261 262 263 264 265 266 267 268 269 270 271 272 273 274 275 276 277 278 279 280 281 282 283 284 285 286 287 288 289 import osimport mathimport torchimport torch.nn as nnimport torch.nn.functional as Ffrom torch.utils.data import DataLoaderfrom torchvision import datasets, transformsfrom torchvision.utils import save_image128 2 10 1e-3 , 3e-4 4 128 4 4 2 10 0.1 "cuda" if torch.cuda.is_available() else "cpu" "output/mini_flux" True )class TinyAutoencoder (nn.Module):"""28x28x1 <-> 14x14x4,MSE 重建训练""" def __init__ (self, latent_ch=4 ):super ().__init__()self .encoder = nn.Sequential(1 , 32 , 3 , stride=2 , padding=1 ), 32 , latent_ch, 3 , padding=1 ),self .decoder = nn.Sequential(32 , 3 , padding=1 ),32 , 1 , 4 , stride=2 , padding=1 ), def forward (self, x ):return self .decoder(self .encoder(x))class SinusoidalTimeEmbedding (nn.Module):def __init__ (self, dim ):super ().__init__()self .dim = dimdef forward (self, t ):self .dim // 2 10000 ) * torch.arange(half, device=t.device) / half)float ()[:, None ] * freqs[None , :]return torch.cat([torch.sin(args), torch.cos(args)], dim=-1 )def sincos_pos_2d (dim, h, w ):"""2D sin-cos 位置编码:前半维度编码行号,后半编码列号。返回 [1, h*w, dim]""" def axis (dim_half, n ):10000 ) * torch.arange(dim_half // 2 ) / (dim_half // 2 ))None ].float () * omega[None , :]return torch.cat([out.sin(), out.cos()], dim=-1 ) 2 , h) 2 , w) None , :].expand(h, w, dim // 2 ),None , :, :].expand(h, w, dim // 2 ),1 )return grid.reshape(1 , h * w, dim)def modulate (x, shift, scale ):"""adaLN 调制: h * (1 + scale) + shift""" return x * (1 + scale) + shiftclass Stream (nn.Module):"""一条流(图像或文本)的全部带参组件""" def __init__ (self, d, mlp_ratio=4 ):super ().__init__()self .norm1 = nn.LayerNorm(d, elementwise_affine=False , eps=1e-6 )self .qkv = nn.Linear(d, 3 * d)self .attn_out = nn.Linear(d, d)self .norm2 = nn.LayerNorm(d, elementwise_affine=False , eps=1e-6 )self .mlp = nn.Sequential(self .adaLN = nn.Sequential(nn.SiLU(), nn.Linear(d, 6 * d))self .adaLN[-1 ].weight)self .adaLN[-1 ].bias)class MMDiTBlock (nn.Module):"""双流 block:图像/文本两套参数,唯一交互点是一次无参的联合 attention""" def __init__ (self, d, n_heads ):super ().__init__()self .n_heads = n_headsself .img = Stream(d)self .txt = Stream(d)def _qkv (self, stream, x, cond ):"""一条流的前半:adaLN 调制 + QKV 投影""" None , :].chunk(6 , dim=-1 )3 , dim=-1 )return q, k, v, (g1, s2, c2, g2)def _out (self, stream, x, attn, gates ):"""一条流的后半:输出投影 + 门控残差 + MLP""" return xdef forward (self, img, txt, cond ):self ._qkv(self .img, img, cond)self ._qkv(self .txt, txt, cond)1 )1 )1 )self .n_headsself .n_heads, hd).transpose(1 , 2 ) for u in (q, k, v))1 , 2 ).reshape(B, N, d)1 ]self ._out(self .txt, txt, o[:, :n_txt], gt) self ._out(self .img, img, o[:, n_txt:], gi) return img, txtclass MiniFluxDiT (nn.Module):"""patchify -> N x MMDiTBlock -> final layer -> unpatchify,预测速度 v""" def __init__ (self, ch=4 , size=14 , patch=2 , d=128 , n_heads=4 , depth=4 ):super ().__init__()self .patch, self .ch = patch, chself .grid = size // patch self .patch_embed = nn.Conv2d(ch, d, kernel_size=patch, stride=patch)self .register_buffer("pos" , sincos_pos_2d(d, self .grid, self .grid))self .time_mlp = nn.Sequential(self .label_emb = nn.Embedding(NUM_CLASSES + 1 , d) self .blocks = nn.ModuleList([MMDiTBlock(d, n_heads) for _ in range (depth)])self .final_norm = nn.LayerNorm(d, elementwise_affine=False , eps=1e-6 )self .final_adaLN = nn.Sequential(nn.SiLU(), nn.Linear(d, 2 * d))self .final_proj = nn.Linear(d, patch * patch * ch)self .final_adaLN[-1 ].weight)self .final_adaLN[-1 ].bias)self .final_proj.weight)self .final_proj.bias)def forward (self, z, t, y ):"""z: [B,4,14,14]; t: [B] float in [0,1]; y: [B] 类别(10 = null)""" self .patch_embed(z).flatten(2 ).transpose(1 , 2 ) + self .pos self .label_emb(y)[:, None , :] self .time_mlp(t * 1000 ) + self .label_emb(y) for blk in self .blocks:self .final_adaLN(cond)[:, None , :].chunk(2 , dim=-1 )self .final_proj(modulate(self .final_norm(img), s, c)) 0 ], self .patch, self .grid, self .ch0 , 5 , 1 , 3 , 2 , 4 )return out.reshape(B, ch, g * p, g * p) def sample_t (batch, device ):"""logit-normal 时间采样: t = sigmoid(N(0,1)),密度集中在中间时刻""" return torch.sigmoid(torch.randn(batch, device=device))def get_dataloader ():0.5 ,), (0.5 ,)), "./data" , train=True , download=True , transform=transform)return DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True ,2 , drop_last=True )def train ():14 , PATCH, D_MODEL, N_HEADS, DEPTH).to(DEVICE)for epoch in range (AE_EPOCHS):0.0 for x, _ in loader:print (f"[AE] epoch {epoch+1 } /{AE_EPOCHS} recon_loss={total/len (loader):.5 f} " )False ).eval ()with torch.no_grad():next (iter (loader))print (f"latent_std = {latent_std:.3 f} " )for epoch in range (DIFF_EPOCHS):0.0 for x, y in loader:with torch.no_grad():0 ], device=DEVICE) < CFG_DROP_PROB0 ], DEVICE) 1 , 1 , 1 , 1 )1 - t_bc) * z0 + t_bc * eps print (f"[FM] epoch {epoch+1 } /{DIFF_EPOCHS} loss={total/len (loader):.4 f} " )"model" : model.state_dict(), "ae" : ae.state_dict(),"latent_std" : latent_std}, f"{SAVE_DIR} /mini_flux.pt" )10 , device=DEVICE),20 , w=3.0 , fname=f"{SAVE_DIR} /epoch_{epoch+1 :03d} .png" )@torch.no_grad() def sample (model, ae, latent_std, y, steps=20 , w=3.0 , fname=None ):""" 解 ODE dz/dt = v_θ(z,t,c),从 t=1(纯噪声)积分到 t=0(数据)。 steps: Euler 步数(FLUX 式采样,20 步即可) w: CFG 引导强度 """ eval ()0 ]14 , 14 , device=DEVICE) 1.0 / stepsfor i in range (steps):1.0 - i * dt, device=DEVICE) 1 , 1 ) + 1 ) / 2 if fname:return xif __name__ == "__main__" :
运行方式:
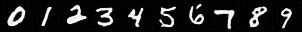
与 mini_sd 相同的训练流程:先训 AE,再训扩散模型。区别是采样只需 20 步
训练完成后的条件生成结果(0~9 每类各一张,20 步 Euler,w = 3.0 w=3.0 w = 3.0
18. 代码与公式的对应关系(Mini FLUX)
公式
代码位置
t = sigmoid ( u ) , u ∼ N ( 0 , 1 ) t = \text{sigmoid}(u),\ u\sim\mathcal{N}(0,1) t = sigmoid ( u ) , u ∼ N ( 0 , 1 ) sample_t()
z t = ( 1 − t ) z 0 + t ϵ z_t = (1-t)z_0 + t\epsilon z t = ( 1 − t ) z 0 + t ϵ train() 中的 zt
v = ϵ − z 0 v = \epsilon - z_0 v = ϵ − z 0 train() 中的 v_target
L F M = ∣ v θ ( z t , t , c ) − v ∣ 2 \mathcal{L}_{FM} = |v_\theta(z_t,t,c) - v|^2 L F M = ∣ v θ ( z t , t , c ) − v ∣ 2 F.mse_loss(v_pred, v_target)
patchify [ B , 4 , 14 , 14 ] → [ B , 49 , d ] [B,4,14,14]\to[B,49,d] [ B , 4 , 14 , 14 ] → [ B , 49 , d ]
patch_embed(2 × 2 2\times2 2 × 2 flatten
modulate ( h ) = h ( 1 + scale ) + shift \text{modulate}(h) = h(1+\text{scale})+\text{shift} modulate ( h ) = h ( 1 + scale ) + shift modulate()
adaLN-Zero 6 组调制参数
Stream.adaLN(输出 6 d 6d 6 d
双流联合 attention
MMDiTBlock.forward() 中的 torch.cat + SDPA
Euler 步 z ← z − v θ Δ t z \leftarrow z - v_\theta\,\Delta t z ← z − v θ Δ t
sample() 中的 z = z - v * dt
CFG v ~ = v ∅ + w ( v c − v ∅ ) \tilde v = v_\varnothing + w(v_c - v_\varnothing) v ~ = v ∅ + w ( v c − v ∅ )
sample() 中的 v_uncond + w * (v_cond - v_uncond)
三代实现横向对比
三部分实现共享同一 MNIST 实验平台,每一代只改动少量组件,便于对照学习:
组件
DDPM(第一部分)
Mini SD(第二部分)
Mini FLUX(第三部分)
扩散空间
像素 28 × 28 × 1 28\times28\times1 28 × 28 × 1
潜空间 14 × 14 × 4 14\times14\times4 14 × 14 × 4
潜空间 14 × 14 × 4 14\times14\times4 14 × 14 × 4
时间定义
离散 t ∈ { 1..1000 } t\in\{1..1000\} t ∈ { 1..1000 }
离散 t ∈ { 1..1000 } t\in\{1..1000\} t ∈ { 1..1000 }
连续 t ∈ [ 0 , 1 ] t\in[0,1] t ∈ [ 0 , 1 ]
加噪/插值
α ˉ t x 0 + 1 − α ˉ t ϵ \sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon α ˉ t x 0 + 1 − α ˉ t ϵ 同左(x → z x\to z x → z
( 1 − t ) z 0 + t ϵ (1-t)z_0+t\epsilon ( 1 − t ) z 0 + t ϵ
预测目标
噪声 ϵ \epsilon ϵ
噪声 ϵ \epsilon ϵ
速度 v = ϵ − z 0 v=\epsilon-z_0 v = ϵ − z 0
主干网络
U-Net
条件 U-Net
双流 MMDiT
条件
无
类别 embedding 加法注入
类别 embedding,双流 + adaLN
CFG
无
训练丢弃 + 双前向外推
同左(公式不变)
采样器
DDPM 1000 步 / DDIM 50 步
DDIM 50 步 + CFG
Euler 20 步 + CFG
典型推理次数
1000 / 50
50 × 2(CFG 双前向)
20 × 2(CFG 双前向)
建议的对照实验:
同一初始噪声、不同实现 :观察条件控制(w)与采样步数对质量的影响曲线;mini_sd 用 20 步 DDIM vs mini_flux 用 20 步 Euler :直观感受直线路径对少步采样的友好程度;把 mini_flux 的 MMDiT 换回 CondUNet (保持 Flow Matching 不变):隔离"训练目标"与"主干网络"两个变量的贡献。
常见问题与调优方向
DDPM/DDIM(第一部分)
采样速度慢 :DDPM 需要 T = 1000 T=1000 T = 1000 DDIM (跳步采样,10~50 步即可),或进一步学习更先进的加速采样器(如 DPM-Solver)。生成质量差 :增大 U-Net 通道数、延长训练、使用 EMA(指数滑动平均)权重采样,都有明显提升。损失不降 :检查图像是否归一化到 [ − 1 , 1 ] [-1,1] [ − 1 , 1 ] 条件生成 :第一部分的实现是无条件生成。把类别标签 embedding 以与时间嵌入相同的方式加入网络,即可生成指定数字(这正是第二部分的起点)。
Mini SD(第二部分)
生成结果与类别不符 :增大 CFG 的 w(如 3.0 → 5.0);检查条件是否真正注入(把 w 设为 0 对比,若结果无变化说明条件没起作用)。w 太大图像过饱和/伪影w,或对 z0_pred 做 clamp。重建模糊 :AE 容量太小或训练不足。可加深 AE、增加 AE_EPOCHS,或把 MSE 换成感知损失;真实 SD 用 KL-VAE + GAN 损失就是这个原因。潜变量尺度异常 :跳过 latent_std 归一化会导致加噪调度失配,损失难降、采样失败。更换 AE 结构后必须重新估计 latent_std。想生成文字描述而非类别 :把 label_emb 换成 CLIP/BERT 等文本编码器,把条件注入从"投影相加"换成 cross-attention,即得到真正的文生图结构(参看第三部分的双流结构)。从 MNIST 迁移到真实图像 :结构无需改变,只需要更强的 AE(下采样 4~8 倍)、更深的 U-Net(多级分辨率 + attention)和更大的数据。
Mini FLUX(第三部分)
与 mini_sd 对比实验 :同一 AE、同一 CFG,只换训练目标/采样器/主干。可以观察:20 步 Euler 与 50 步 DDIM 的质量差异;MMDiT 与 U-Net 的收敛速度差异。采样步数 :Flow Matching 的直线路径让 5~10 步也能得到可辨认结果,可以试 steps=5 对比 steps=50,直观理解"路径越直、离散误差越小"。训练不稳定 :adaLN-Zero 和 final_proj 的零初始化是稳定性的关键,去掉后 loss 初期会剧烈震荡——可以做个消融验证。t 的采样分布 :把 logit-normal 换成均匀分布,中间噪声水平训练不足,采样中段质量下降明显(又一个可做的消融)。扩展到真实文生图 :类别 embedding 换成 T5 编码的多 token 文本序列(文本流长度从 1 变为数百)、sin-cos 位置编码换成 RoPE、加深/加宽 MMDiT——即得到 FLUX 的完整结构。更快的采样 :Euler 是一阶方法,换成 Heun/中点法(二阶)可以在更少步数下保持质量,这也是各开源 FLUX pipeline 的常见优化。
参考文献
Ho et al., Denoising Diffusion Probabilistic Models (DDPM), NeurIPS 2020
Song et al., Denoising Diffusion Implicit Models (DDIM), ICLR 2021
Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models (LDM / Stable Diffusion), CVPR 2022
Ho & Salimans, Classifier-Free Diffusion Guidance , NeurIPS 2021 Workshop
Radford et al., Learning Transferable Visual Models From Natural Language Supervision (CLIP), ICML 2021
Esser et al., Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (SD3 / MMDiT), ICML 2024
Liu et al., Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow , ICLR 2023
Lipman et al., Flow Matching for Generative Modeling , ICLR 2023
Peebles & Xie, Scalable Diffusion Models with Transformers (DiT / adaLN-Zero), ICCV 2023
Black Forest Labs, FLUX.1 , 2024
Luo, Understanding Diffusion Models: A Unified Perspective , 2022